Construida para la confianza cero, pensada para componerse
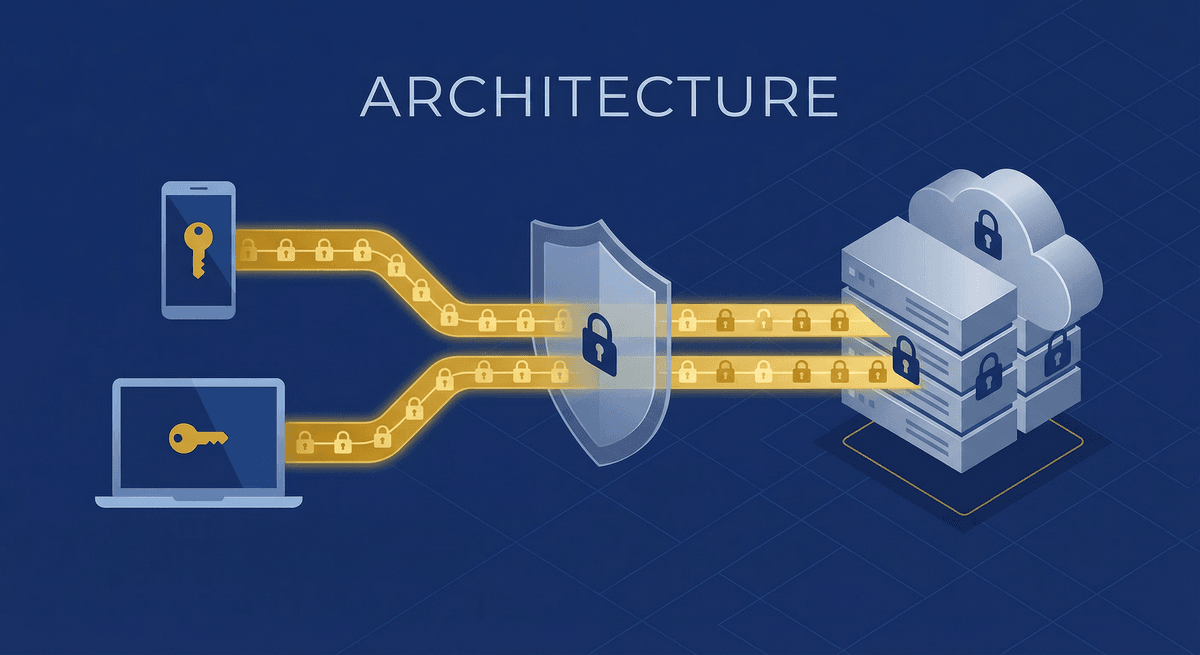
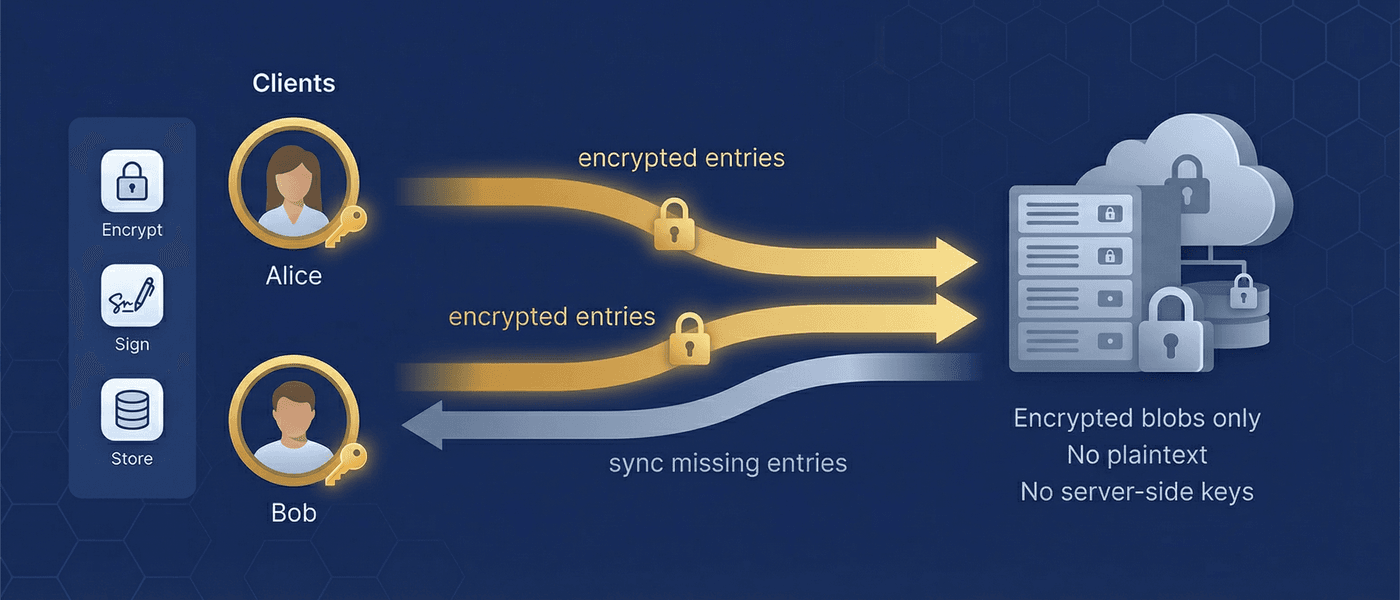
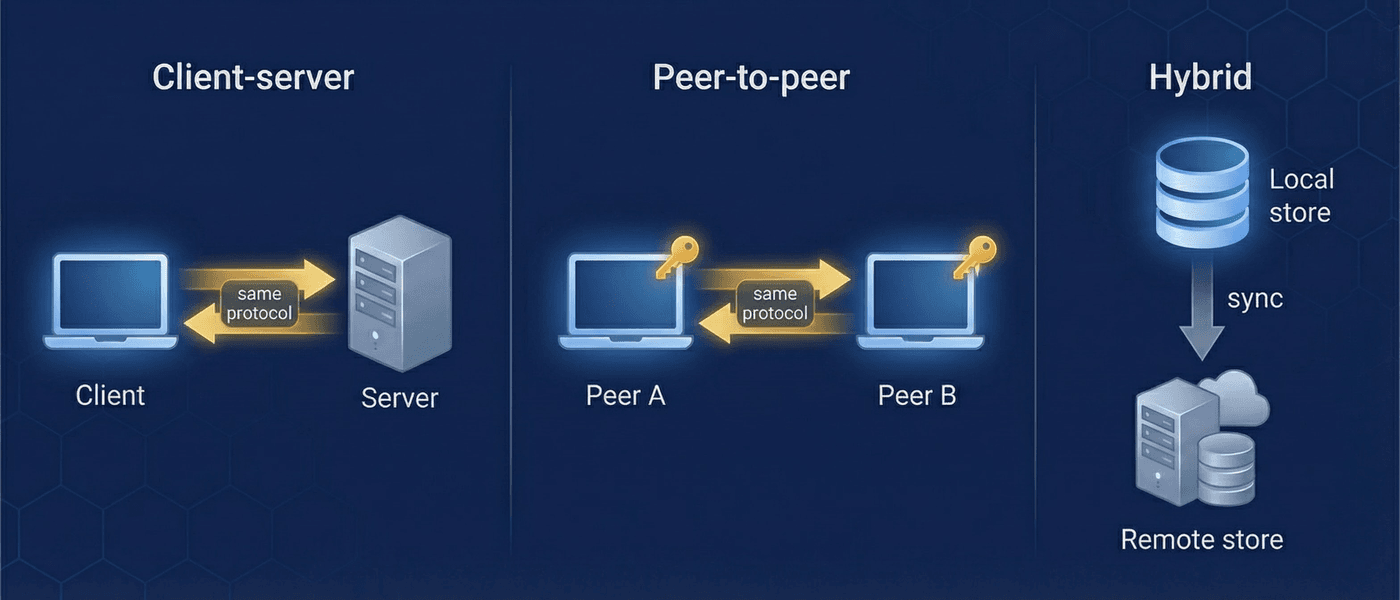
La arquitectura de MindooDB separa la tarea de sincronizar (transportar bytes cifrados) de la tarea de la aplicación (descifrar e interpretar los datos). Esta única decisión de diseño hace posibles las topologías cliente-servidor, peer-to-peer, de relay y de malla — todas con el mismo protocolo y el mismo código.
Lo que esta arquitectura te aporta
Si estás evaluando MindooDB para tu equipo, la pregunta clave sobre la arquitectura es: ¿puedo adoptarlo paso a paso sin lock-in? La respuesta es sí. MindooDB está pensado para una adopción progresiva: empieza solo en local, añade la sincronización cliente-servidor cuando te convenga y activa más tarde las topologías P2P o de relay. Cada paso usa la misma interfaz ContentAddressedStore, así que cambiar de modelo de despliegue es una decisión de configuración y no una reescritura de código.
Horas para el uso solo local. Días para la sincronización cliente-servidor (2 endpoints de autenticación + 3 de sincronización). Paso a paso para P2P, relay u optimizaciones con filtros de Bloom — sin cambiar el protocolo.
Tres capas de protección independientes: AES-256-GCM en reposo, RSA por usuario en tránsito y TLS en la conexión. Los servidores nunca ven texto en claro. Una brecha total del servidor solo entrega texto cifrado y claves públicas.
Sin cuentas de usuario en el servidor, sin contraseñas almacenadas, sin bases de datos de sesión. El servidor es un relay para blobs cifrados. La gestión de usuarios ocurre en el cliente, mediante pares de claves criptográficas.
Tenants, usuarios y la cadena de confianza
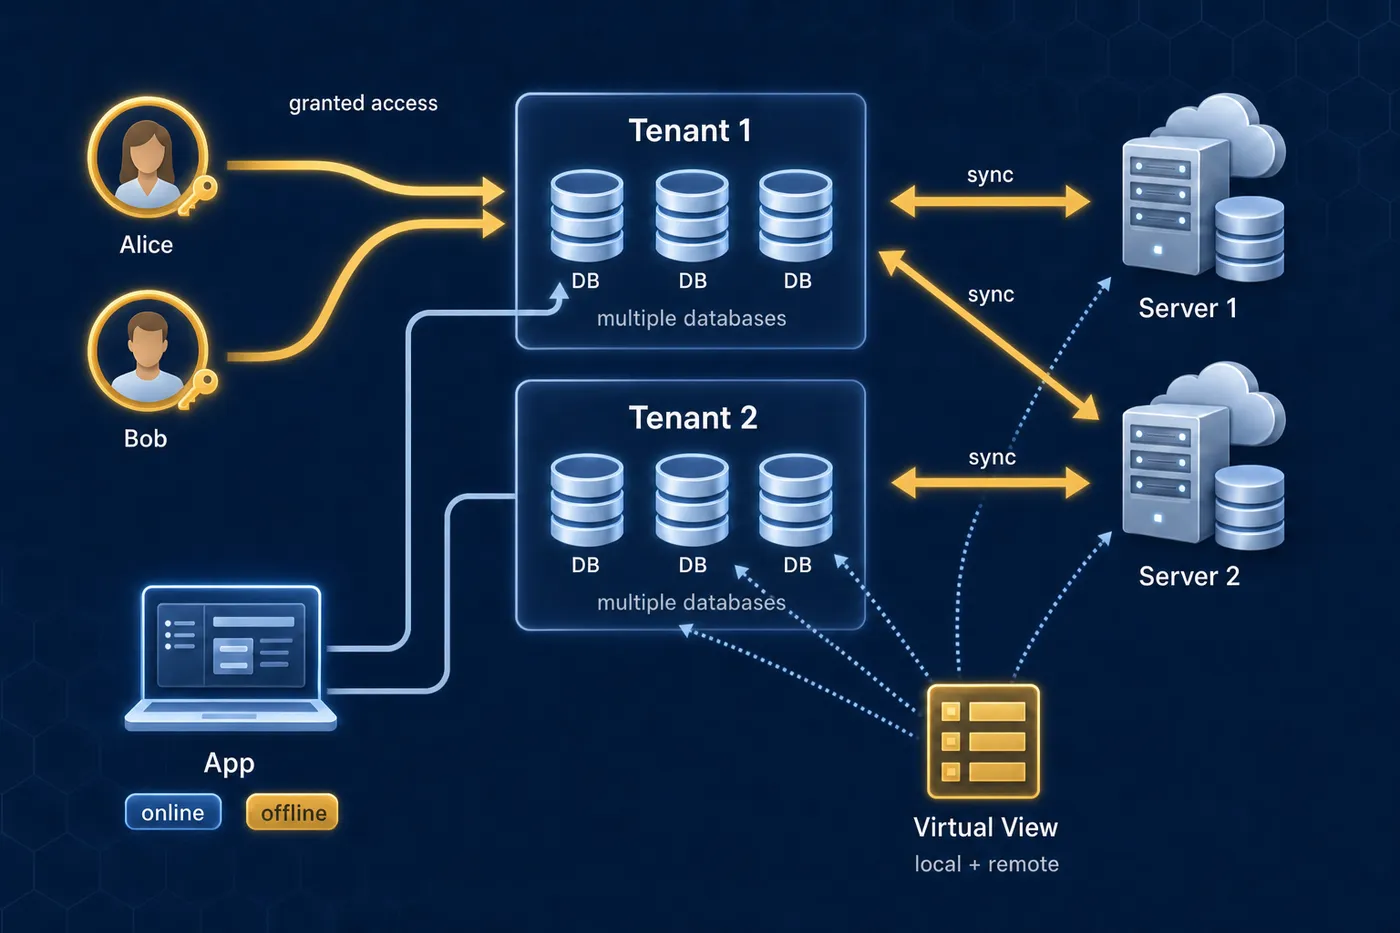
Un tenant de MindooDB representa una organización o un equipo. Los tenants se crean íntegramente en el cliente: no hace falta registrarlos en un servidor. Quien crea el tenant se convierte en su administrador, y su clave de firma Ed25519 es la raíz de confianza. Cada registro de usuario en el directorio se firma con esa clave de administrador, y tanto los clientes como los servidores verifican esas firmas antes de confiar en la clave pública de un usuario. La confianza se establece así mediante pruebas criptográficas, no mediante una autenticación en el servidor.
Cada tenant contiene una base de datos de directorio (el registro de usuarios, solo para administradores), varias bases de datos de aplicación y las claves que controlan el acceso.
- Base de datos del directorio — Registros de usuario firmados por el administrador, pertenencias a grupos, ajustes
- Bases de datos de aplicación — Se crean cuando se necesitan (
tenant.openDB("contacts")) - Documentos — CRDT de Automerge con historial firmado, cifrado y append-only
- Adjuntos — Almacenamiento de archivos en fragmentos de 256 KB, cifrado y deduplicado
La confianza fluye desde la clave de administrador, a través del directorio, hasta los usuarios registrados. Cada tipo de clave cumple un propósito concreto:
- Clave de firma del administrador (Ed25519) — Raíz de confianza; firma las entradas del directorio
- Clave de cifrado del administrador (RSA-OAEP) — Cifra los nombres de usuario por privacidad
- Claves de firma de usuario (Ed25519) — Acreditan la autoría de los cambios en documentos
- Claves de cifrado de usuario (RSA-OAEP) — Protegen el KeyBag guardado en local
- Clave de tenant predeterminada (AES-256) — Cifra los documentos para todos los miembros
- Claves con nombre (AES-256) — Acceso granular para usuarios concretos
El almacén direccionado por contenido
En el centro de la flexibilidad de MindooDB está la interfaz ContentAddressedStore. Todo almacén — ya esté respaldado por el disco local, por datos en memoria o por una conexión de red remota — implementa esa misma interfaz. Los métodos de sincronización pullChangesFrom() y pushChangesTo() aceptan cualquier ContentAddressedStore, así que funcionan igual tanto si el otro lado es un almacén local como un servidor remoto por HTTP o Iroh, u otro cliente conectado por Iroh.
Esta es la idea de diseño que hace posible cualquier topología: al implementar los almacenes de red la misma interfaz que los locales, la sincronización se vuelve componible. El almacén de respaldo de un servidor puede ser a su vez un almacén remoto (encadenamiento de almacenes). Un relay puede reenviar entradas cifradas sin descifrarlas. Un peer puede ejecutar la misma lógica de sincronización que un servidor. La topología es una decisión de despliegue, no un cambio de código.
Cada cambio en un documento, cada snapshot y cada fragmento de adjunto se guarda como una entrada inmutable con un ID único y un hash de contenido. Las entradas nunca se modifican ni se borran, lo que garantiza un registro de auditoría completo.
Cada entrada referencia por ID a sus entradas padre (formando un DAG) y va firmada por quien la creó. Manipular una entrada rompe la cadena: la integridad es verificable en cualquier punto.
Las entradas se identifican por id y se deduplican por contentHash (SHA-256 del payload cifrado). El contenido idéntico procedente de varias fuentes se guarda una sola vez.
Empieza simple, optimiza después
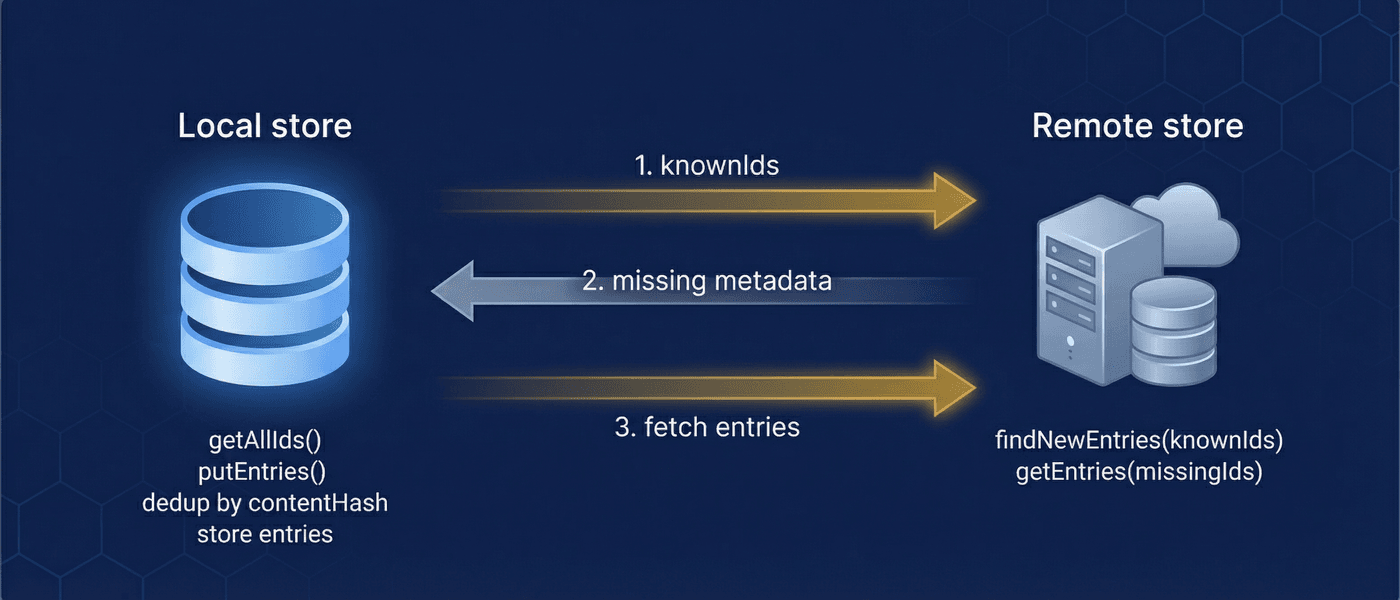
El protocolo de sincronización ofrece tres caminos que comparten los mismos endpoints y el mismo modelo de entradas. El sync baseline es el más simple: envías los IDs de entrada que conoces, recibes los metadatos de lo que te falta y recuperas esas entradas. Sirve para cualquier volumen de datos y es el punto de partida recomendado. El sync optimizado añade escaneo con cursor y resúmenes con filtro de Bloom para conjuntos de datos mayores; ambos se negocian en tiempo de ejecución mediante descubrimiento de capacidades, así que son transparentes para el código de la aplicación. El dense sync usa el planificador de materialización causal y transfiere solo las entradas necesarias para el estado actual de cada documento — el mejor snapshot más los cambios que no cubre —, se salta las entradas históricas y deja los adjuntos para después. Ideal para la primera configuración en móvil con poco ancho de banda.
Estas invariantes se cumplen en todas las topologías de despliegue — cliente-servidor, P2P, cadenas de relay y malla:
- Completitud — Tras un ciclo completo de sincronización, el cliente conoce los metadatos de todas las entradas remotas
- Idempotencia — Cada endpoint se puede llamar tantas veces como haga falta, sin efectos secundarios
- Independencia del orden — Las entradas pueden llegar en cualquier orden; de la convergencia se encargan los CRDT
- Deduplicación — Las entradas idénticas de varias fuentes se guardan una sola vez
A partir de decenas de miles de entradas, dos técnicas mantienen la sincronización rápida:
- Escaneo con cursor — Recorrer los metadatos remotos por páginas en lugar de enviar listas largas de IDs. El tamaño de la petición se mantiene constante, sea cual sea el tamaño total del almacén.
- Resumen con filtro de Bloom — Descargar una representación probabilística compacta del conjunto para prefiltrar los IDs. Ahorra entre el 90 y el 99 % de las comprobaciones exactas de existencia.
- Snapshots CRDT — Los snapshots periódicos evitan que reproducir historiales largos acabe lastrando el rendimiento.
- Dense sync — Transferir de cada documento solo el último snapshot y los cambios que no cubre, sin historial ni adjuntos. Más información →
Toda operación de sincronización exige autenticarse mediante un flujo de desafío y respuesta: el cliente firma con su clave Ed25519 un desafío generado por el servidor y este emite un JWT de corta duración. La revocación se aplica en dos puntos — al generar el desafío y al validar el token —, así que un usuario revocado queda fuera de inmediato, incluso en mitad de una sesión. En el servidor no se guardan contraseñas ni tokens. El mismo desafío y el mismo JWT se aplican cuando el servidor se alcanza por Iroh: el ticket sustituye la dirección, no la comprobación. Un enlace de dispositivo a dispositivo no tiene JWT — el dispositivo que recibe autoriza él mismo a quien llama.
El mismo protocolo, cualquier forma de red
Como la sincronización trabaja sobre entradas cifradas y usa en todas partes la misma interfaz ContentAddressedStore, cualquier nodo puede participar en ella sin descifrar los datos. Un servidor de relay guarda y reenvía entradas que no puede leer. Una caché regional sirve entradas a los clientes cercanos sin necesitar claves. La frontera de confianza está en las claves de cifrado, no en la topología de red.
Despliegue estándar con un servidor central. Es el más sencillo de montar y de operar. El servidor valida a los usuarios a través del directorio, guarda las entradas cifradas y sincroniza con los clientes conectados. HTTP es el valor por defecto. Un servidor sin URL pública puede en su lugar escuchar en Iroh y alcanzarse con un ticket iroh: — sin DynDNS, redirección de puertos ni certificado.
Dos dispositivos del mismo tenant sincronizan directamente por Iroh (QUIC), sin un servidor MindooDB en el camino. Los clientes nativos intentan primero un camino directo y, si no, caen a un relay; una pestaña del navegador va siempre por un relay. El dispositivo que recibe comprueba él mismo las firmas y las reglas de acceso, porque un peer no emite un recibo de testigo. La misma API pullChangesFrom/pushChangesTo que en cliente-servidor.
Los datos pasan por nodos que no pueden descifrarlos. El servidor de un hospital sincroniza historiales de pacientes entre clínicas sin leerlos. Un nodo de paso reenvía las peticiones a un servidor de origen, útil para caché en el borde o para delimitar accesos.
| Topología | Cuándo usarla | Infraestructura necesaria | Ventaja principal |
|---|---|---|---|
| Cliente-servidor | Punto de partida habitual; sincronización fiable y permanente | Un servidor + clientes (HTTP o Iroh) | El despliegue más simple |
| Peer-to-peer | Sincronización de dispositivo a dispositivo, sin servidor MindooDB en el camino | Clientes + Iroh (relay si el NAT bloquea) | Sin servidor en el camino |
| Relay | Distribuir datos a través de nodos no confiables | Servidor de relay (sin claves) | Distribución segura |
| Cadena de almacenes | Caché en el borde, distribución geográfica | Origen + nodos de borde | Menos latencia |
| Malla | Convergencia robusta entre varios peers | Varios peers | Sin punto único de fallo |
| Híbrida | Servidor para fiabilidad, peers mientras está caído | Servidor + enlaces directos entre peers | Lo mejor de ambos |
Resistencia a caídas e integridad de los datos
MindooDB guarda entradas cifradas y direccionadas por contenido directamente en el sistema de archivos. Así el almacén controla por completo el orden de los commits, la recuperación tras una caída y la deduplicación, sin depender de un motor de base de datos embebido como SQLite o LevelDB.
Cada escritura en disco sigue un protocolo atómico: escribir en un archivo temporal, fsync, renombrar de forma atómica y hacer fsync del directorio padre. Quien lee nunca ve un estado a medio escribir. El orden de confirmación (primero el payload, luego los metadatos y después el segmento de índice) garantiza que una entrada solo se vuelve localizable cuando su payload ya está a salvo en disco.
- Caída entre el payload y los metadatos — El payload huérfano es inocuo
- Caída entre los metadatos y el índice — La entrada queda confirmada; el índice se reconstruye al arrancar
- Caída durante la compactación — El índice obsoleto se detecta y se reconstruye a partir de los archivos de entrada, que son la referencia
Al arrancar, el almacén intenta primero la recuperación rápida: cargar el snapshot de metadatos, reproducir los segmentos incrementales y validarlos contra los archivos de entrada, que son la referencia. Si algo está obsoleto o es inconsistente, recurre a una reconstrucción completa desde el disco, de forma transparente y sin pérdida de datos.
- Índices en memoria — Búsquedas puntuales O(1), escaneos de cursor por búsqueda binaria, consultas por documento
- Compactación de segmentos — Fusiona los metadatos incrementales en snapshots nuevos para que el arranque siga siendo rápido
- Fuente de verdad — Los archivos de entrada en disco son siempre la referencia; los archivos de índice son estructuras de aceleración y se pueden borrar sin riesgo
El análisis a fondo de la implementación está en la documentación del almacén en disco.
Organizar los datos para que crezcan
La arquitectura append-only de MindooDB implica que los datos se acumulan con el tiempo. Como cada cambio se conserva para el registro de auditoría, merece la pena planificar ese crecimiento. La herramienta principal es el sharding a nivel de base de datos: repartir los datos en bases de datos separadas por periodo, categoría, nivel de acceso o región. Cada base de datos sincroniza por su cuenta, así que controlas exactamente qué datos van a dónde.
- Por tiempo — Bases de datos anuales o mensuales que aceleran la sincronización de los datos activos y conservan el historial
- Por categoría — Bases de datos separadas por tipo de documento, proyecto o unidad de negocio
- Por acceso — Aislar los datos por nivel de seguridad para que cada equipo sincronice un subconjunto distinto
- Por región — Una base de datos por región para los requisitos de residencia de datos
Los documentos están cifrados en reposo, así que no hay consultas en el servidor. En su lugar, MindooDB ofrece indexación incremental en el cliente:
- Procesamiento con cursor —
iterateChangesSince(cursor)procesa solo los documentos que han cambiado desde la última pasada - Indexadores intercambiables — Enviar los cambios a FlexSearch, Lunr o cualquier índice propio
- Vistas virtuales — Categorizadas al estilo de una hoja de cálculo, con ordenación y agregación, a través de varias bases de datos o tenants
Aislamiento de tenants y colaboración entre tenants
Los tenants están aislados criptográficamente por defecto: cada uno tiene sus propias claves de cifrado, su propio directorio de usuarios y su propio conjunto de bases de datos. La colaboración entre tenants es posible compartiendo bases de datos concretas o claves de cifrado con nombre, sin que ninguno pierda su administración independiente.
- Cada tenant tiene claves de cifrado propias — sin secretos compartidos
- Directorios de usuario separados, con claves de administrador propias
- Los datos están aislados por defecto; compartirlos exige distribuir claves de forma explícita
- Revocar a un usuario en un tenant no afecta a los demás tenants
- Compartir bases de datos concretas entre tenants con claves con nombre
- Las vistas virtuales pueden agregar datos más allá de los límites de un tenant
- Cada tenant conserva su propia administración y su propia revocación
- Útil para cadenas de suministro, organizaciones socias y proyectos compartidos
Lo que conviene saber antes de adoptarlo
Toda arquitectura implica trade-offs. El cifrado de extremo a extremo y el diseño append-only de MindooDB dan garantías sólidas de seguridad y trazabilidad, pero traen consigo limitaciones que conviene conocer desde el principio.
Revocar a un usuario bloquea toda sincronización futura y rechaza sus cambios posteriores. Sin embargo, los datos ya sincronizados en su dispositivo siguen siendo accesibles: ningún sistema puede garantizar el borrado en un dispositivo que nunca vuelve a conectarse. Mitigación: usa claves con nombre para los documentos sensibles (radio de impacto menor) y rota las claves cuando alguien deja el equipo. Haven Enterprise añade a esas mismas políticas de gobernanza un borrado remoto del dispositivo firmado por el administrador: el tenant se elimina de un dispositivo robado o dado de baja la próxima vez que se conecta.
Como los datos se cifran antes de salir del cliente, el servidor no puede ejecutar consultas. Todo se consulta en el cliente: con indexación incremental, vistas virtuales o indexadores de búsqueda intercambiables. Es un trade-off deliberado: confidencialidad por delante de la comodidad en el servidor.
Varias claves por usuario (firma, cifrado, claves simétricas con nombre) exigen una distribución segura. Mitigación: una sola contraseña desbloquea todas las claves mediante una KDF con sales distintas. El KeyBag ofrece un almacén de claves unificado. El flujo de solicitud y respuesta de unión se encarga del intercambio de claves para los usuarios nuevos. Haven Enterprise automatiza el trabajo del día a día: las políticas de distribución de claves firmadas por el administrador aprovisionan claves a usuarios y grupos — y las revocan de nuevo —, empaquetadas para cada destinatario, y cada cliente reconcilia su KeyBag en la siguiente sincronización.
Los datos se acumulan porque se conserva el registro de auditoría. Mitigación: el sharding a nivel de base de datos limita el crecimiento por unidad de sincronización. Los snapshots CRDT reducen el coste de reproducir el historial. Cuando la normativa obliga a borrar, está disponible la purga RGPD (purgeDocHistory).
MindooDB Haven implementa estas piezas en una PWA que corre en el navegador: las claves se quedan con el usuario, las apps se ejecutan aisladas según sus capacidades, con modos de sincronización flexibles y una plataforma de apps de verdad. Es la forma más rápida de ver MindooDB de principio a fin.