Für Zero Trust gebaut, auf Komponierbarkeit ausgelegt
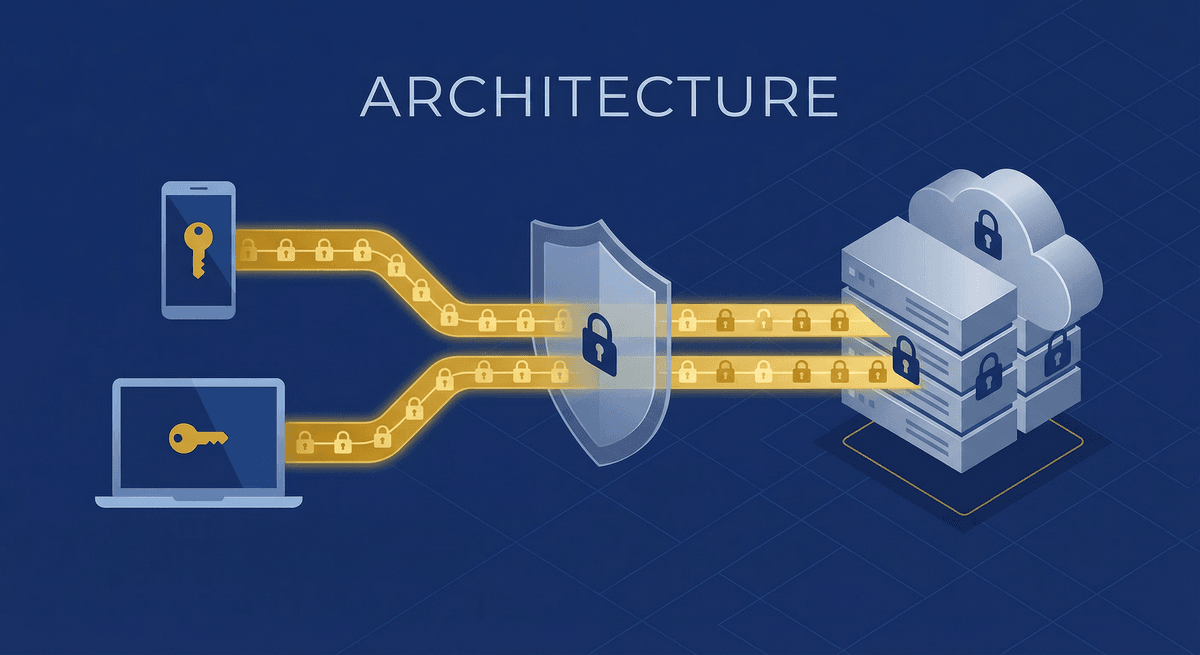
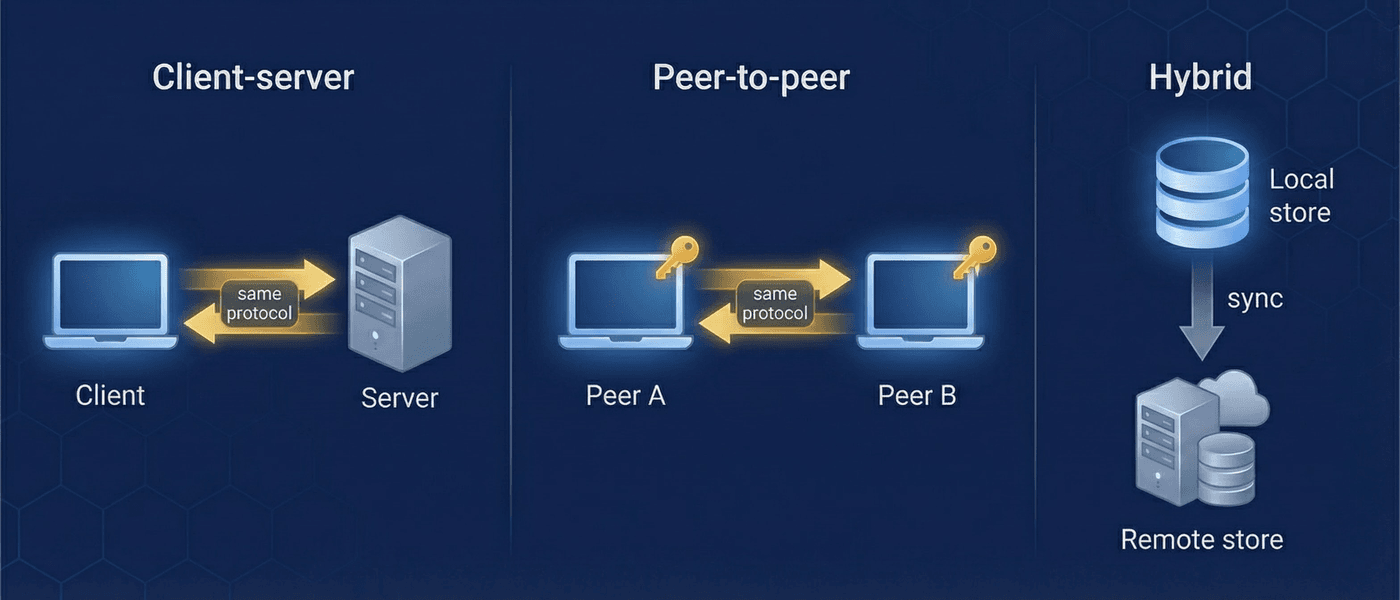
Die Architektur von MindooDB trennt die Sync-Aufgabe (verschlüsselte Bytes transportieren) von der Anwendungsaufgabe (Daten entschlüsseln und interpretieren). Diese eine Designentscheidung ermöglicht Client-Server-, Peer-to-Peer-, Relay- und Mesh-Topologien — alle mit demselben Protokoll und demselben Code.
Was diese Architektur dir bringt
Wenn du MindooDB für dein Team evaluierst, lautet die entscheidende Architekturfrage: Lässt sich das schrittweise einführen, ohne Lock-in? Die Antwort ist ja. MindooDB ist auf schrittweise Einführung ausgelegt — starte rein lokal, ergänze Client-Server-Sync, sobald es passt, und aktiviere P2P- oder Relay-Topologien später. Jeder Schritt nutzt dieselbe ContentAddressedStore-Schnittstelle, ein Wechsel des Deployment-Modells ist also eine Konfigurationsentscheidung und kein Neuschreiben von Code.
Stunden für den rein lokalen Betrieb. Tage für Client-Server-Sync (2 Auth- + 3 Sync-Endpunkte). Schrittweise für P2P, Relay oder Bloom-Filter-Optimierungen — ganz ohne Protokolländerungen.
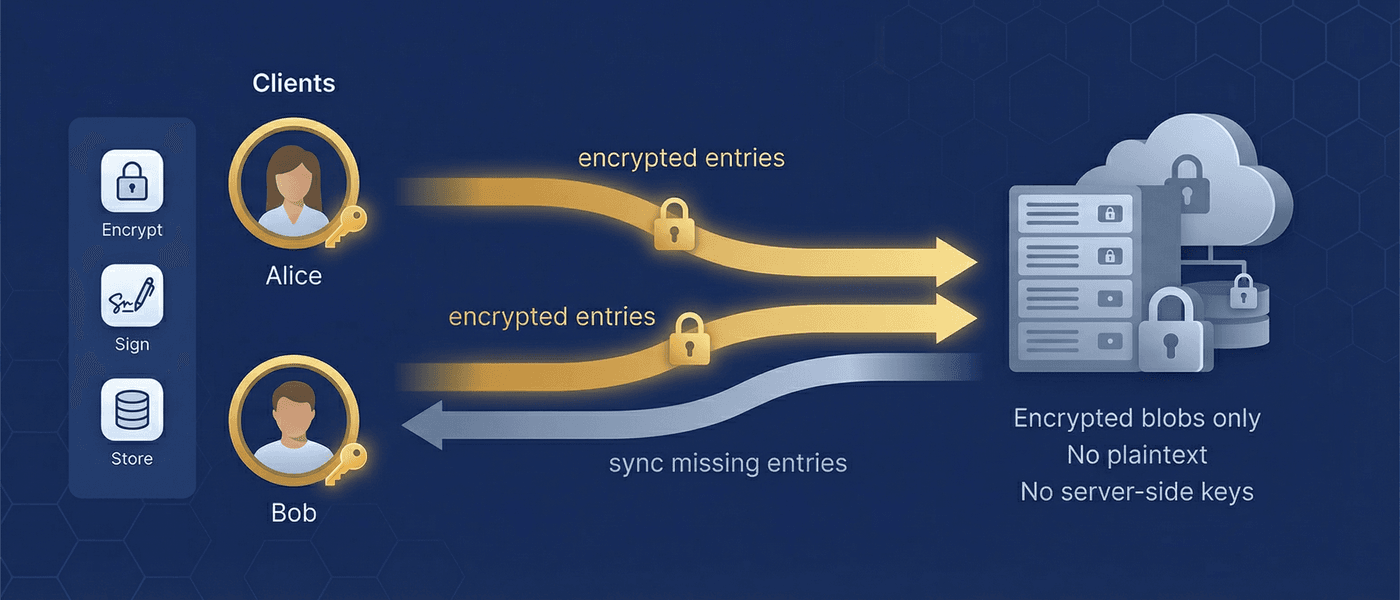
Drei unabhängige Schutzschichten: AES-256-GCM im Ruhezustand, RSA pro Benutzer bei der Übertragung, TLS auf der Leitung. Server sehen nie Klartext. Ein vollständiger Server-Einbruch liefert nur Geheimtext und öffentliche Schlüssel.
Keine serverseitigen Benutzerkonten, keine Passwortspeicherung, keine Session-Datenbanken. Der Server ist ein Relay für verschlüsselte Blobs. Die Benutzerverwaltung läuft clientseitig über kryptografische Schlüsselpaare.
Tenants, Benutzer und die Vertrauenskette
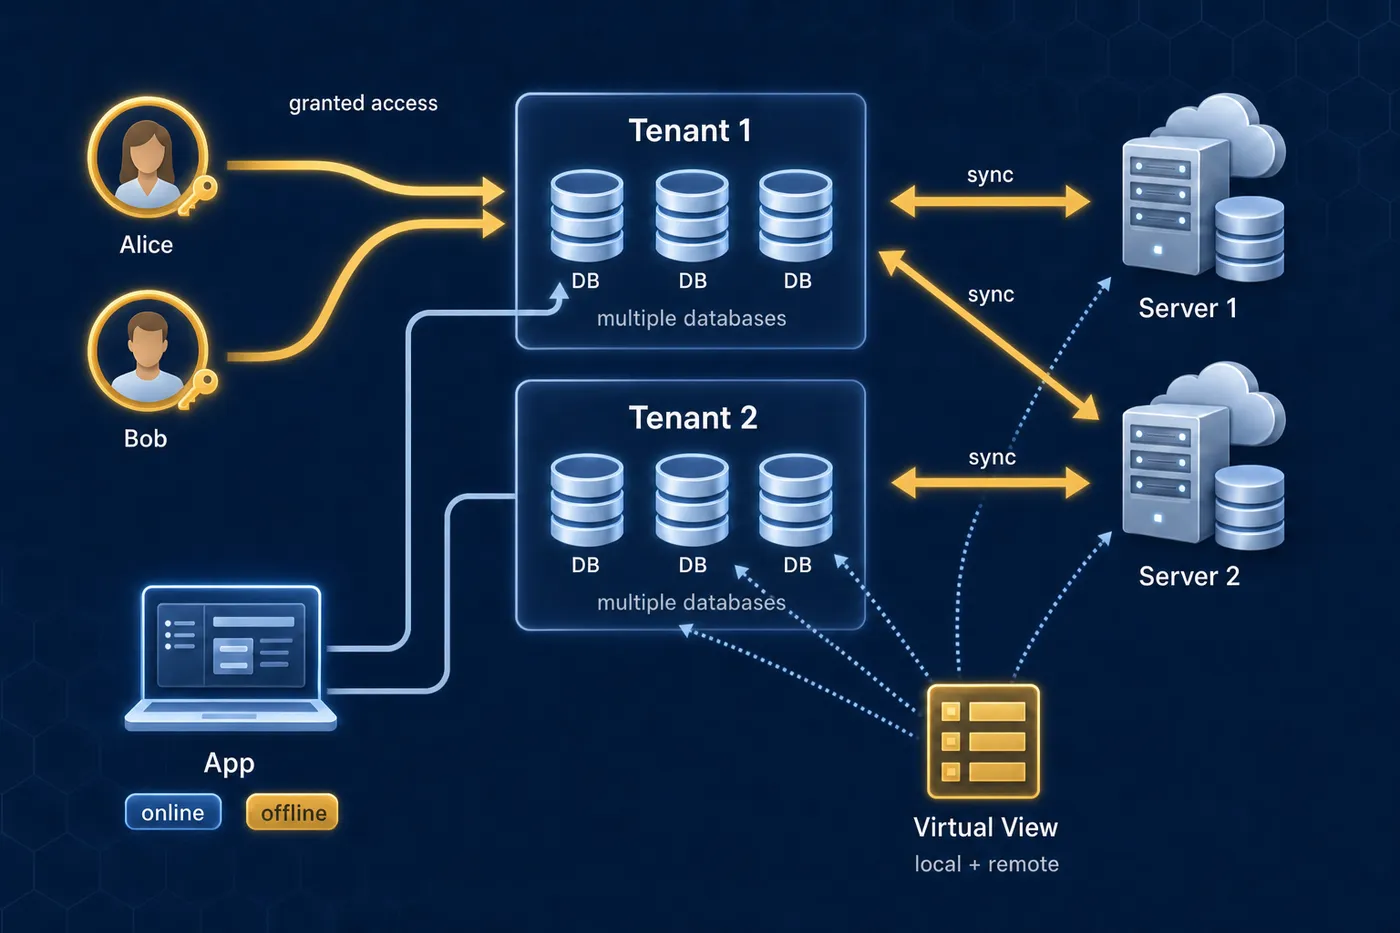
Ein MindooDB-Tenant steht für eine Organisation oder ein Team. Tenants werden vollständig clientseitig angelegt — eine Registrierung auf dem Server ist nicht nötig. Wer einen Tenant anlegt, wird dessen Administrator; sein Ed25519-Signaturschlüssel ist die Vertrauenswurzel. Jede Benutzerregistrierung im Verzeichnis wird mit diesem Admin-Schlüssel signiert, und Clients wie Server prüfen diese Signaturen, bevor sie dem öffentlichen Schlüssel eines Benutzers vertrauen. Vertrauen entsteht damit über kryptografische Beweise, nicht über eine Server-Authentifizierung.
Jeder Tenant enthält eine Verzeichnisdatenbank (Benutzerregister, nur für Admins), mehrere Anwendungsdatenbanken und die Schlüssel, die den Zugriff steuern.
- Verzeichnisdatenbank — Admin-signierte Benutzerregistrierungen, Gruppenmitgliedschaften, Einstellungen
- Anwendungsdatenbanken — Werden bei Bedarf angelegt (
tenant.openDB("contacts")) - Dokumente — Automerge-CRDTs mit signierter, verschlüsselter Append-only-Historie
- Anhänge — Dateispeicher in 256-KB-Chunks, verschlüsselt und dedupliziert
Vertrauen fließt vom Admin-Schlüssel über das Verzeichnis zu den registrierten Benutzern. Jeder Schlüsseltyp hat einen festen Zweck:
- Admin-Signaturschlüssel (Ed25519) — Vertrauenswurzel; signiert Verzeichniseinträge
- Admin-Verschlüsselungsschlüssel (RSA-OAEP) — Verschlüsselt Benutzernamen zum Schutz der Privatsphäre
- Benutzer-Signaturschlüssel (Ed25519) — Belegen die Urheberschaft von Dokumentänderungen
- Benutzer-Verschlüsselungsschlüssel (RSA-OAEP) — Schützen den lokalen KeyBag-Speicher
- Standard-Tenant-Schlüssel (AES-256) — Verschlüsselt Dokumente für alle Mitglieder
- Benannte Schlüssel (AES-256) — Feingranularer Zugriff für einzelne Benutzer
Der content-adressierte Store
Im Zentrum der Flexibilität von MindooDB steht die Schnittstelle ContentAddressedStore. Jeder Store — ob auf der lokalen Festplatte, im Arbeitsspeicher oder hinter einer Netzwerkverbindung — implementiert dieselbe Schnittstelle. Die Sync-Methoden pullChangesFrom() und pushChangesTo() akzeptieren jeden ContentAddressedStore. Sie arbeiten deshalb identisch, egal ob die Gegenstelle ein lokaler Store, ein entfernter Server über HTTP oder Iroh oder ein weiterer Client über Iroh ist.
Genau diese Designidee macht jede Topologie möglich: Weil Netzwerk-Stores dieselbe Schnittstelle implementieren wie lokale Stores, wird Sync komponierbar. Der Backing-Store eines Servers kann selbst ein entfernter Store sein (Store-Chaining). Ein Relay kann verschlüsselte Einträge weiterleiten, ohne sie zu entschlüsseln. Ein Peer kann dieselbe Sync-Logik ausführen wie ein Server. Die Topologie ist eine Deployment-Entscheidung, keine Code-Änderung.
Jede Dokumentänderung, jeder Snapshot und jeder Anhang-Chunk wird als unveränderlicher Eintrag mit eindeutiger ID und Content-Hash gespeichert. Einträge werden nie geändert oder gelöscht — das garantiert einen vollständigen Audit-Trail.
Jeder Eintrag verweist per ID auf seine Eltern-Einträge (das ergibt einen DAG) und ist von seinem Urheber signiert. Wer einen Eintrag manipuliert, zerstört die Kette — die Integrität ist an jeder Stelle überprüfbar.
Einträge werden über id identifiziert und über contentHash (SHA-256 des verschlüsselten Payloads) dedupliziert. Identischer Inhalt aus mehreren Quellen wird nur einmal gespeichert.
Einfach starten, später optimieren
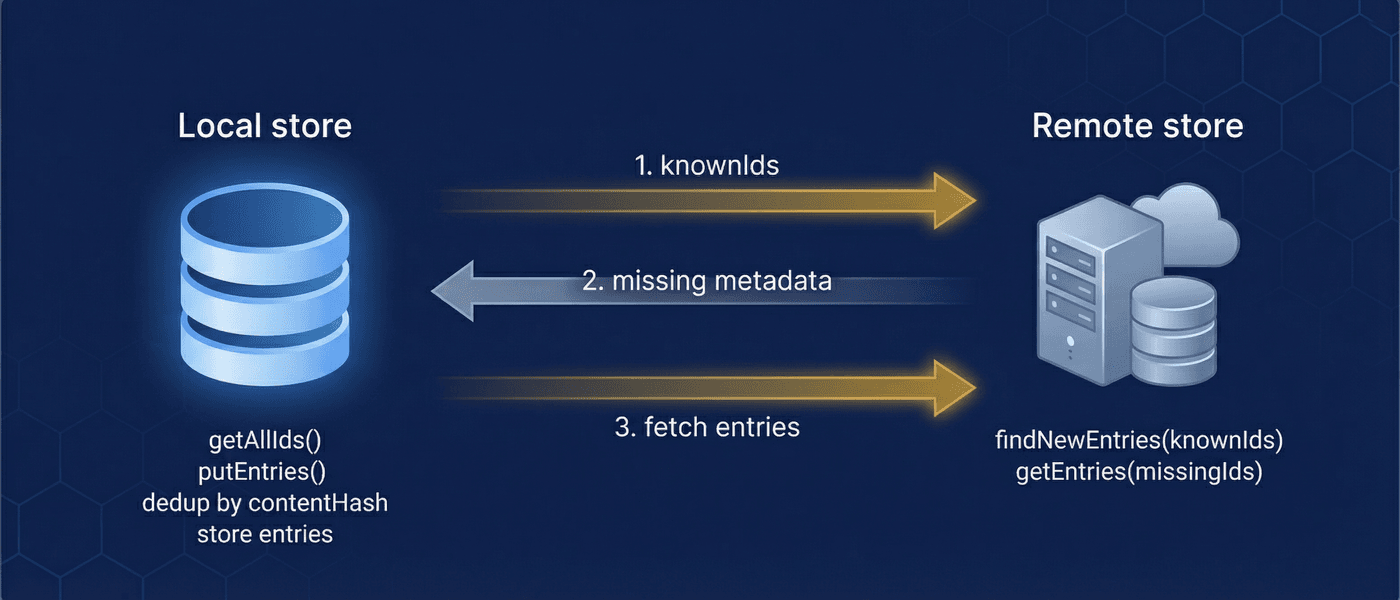
Das Sync-Protokoll bietet drei Wege, die sich dieselben Endpunkte und dasselbe Eintragsmodell teilen. Baseline-Sync ist der einfachste: bekannte Eintrags-IDs schicken, Metadaten zu allem Fehlenden empfangen, diese Einträge holen. Das funktioniert für jede Datenmenge und ist der empfohlene Einstieg. Optimierter Sync ergänzt cursorbasiertes Scannen und Bloom-Filter-Zusammenfassungen für größere Datenmengen — beides wird zur Laufzeit über Capability Discovery ausgehandelt und ist für den Anwendungscode damit transparent. Dense Sync nutzt den kausalen Materialisierungsplaner und überträgt nur die Einträge, die für den aktuellen Dokumentzustand nötig sind — den besten Snapshot plus die davon nicht abgedeckten Änderungen. Historische Einträge bleiben außen vor, Anhänge folgen später. Ideal für die Ersteinrichtung auf Mobilgeräten mit begrenzter Bandbreite.
Diese Invarianten gelten in allen Deployment-Topologien — Client-Server, P2P, Relay-Ketten und Mesh:
- Vollständigkeit — Nach einem vollen Sync-Zyklus kennt der Client die Metadaten jedes entfernten Eintrags
- Idempotenz — Jeder Endpunkt lässt sich beliebig oft aufrufen, ohne Seiteneffekte
- Reihenfolgeunabhängigkeit — Einträge dürfen in beliebiger Reihenfolge eintreffen; die Konvergenz übernehmen CRDTs
- Deduplizierung — Identische Einträge aus mehreren Quellen werden nur einmal gespeichert
Ab einigen Zehntausend Einträgen halten diese Techniken den Sync schnell:
- Cursor-Scanning — Entfernte Metadaten seitenweise durchgehen, statt große ID-Listen zu schicken. Die Größe der Anfrage bleibt konstant, unabhängig von der Gesamtgröße des Stores.
- Bloom-Filter-Zusammenfassung — Eine kompakte probabilistische Mengendarstellung laden und IDs damit vorfiltern. Spart 90-99 % der exakten Existenzprüfungen.
- CRDT-Snapshots — Regelmäßige Snapshots verhindern, dass das Nachspielen langer Dokumenthistorien die Performance drückt.
- Dense Sync — Pro Dokument nur den neuesten Snapshot und die nicht abgedeckten Änderungen übertragen, ohne Historie und Anhänge. Mehr erfahren →
Jede Sync-Operation erfordert eine Authentifizierung per Challenge-Response: Der Client signiert eine vom Server erzeugte Challenge mit seinem Ed25519-Schlüssel, der Server stellt daraufhin ein kurzlebiges JWT aus. Der Widerruf greift an zwei Stellen — beim Erzeugen der Challenge und beim Prüfen des Tokens —, ein widerrufener Benutzer ist also sofort ausgeschlossen, auch mitten in einer Sitzung. Auf dem Server werden weder Passwörter noch Tokens gespeichert. Dieselbe Challenge und dasselbe JWT gelten, wenn der Server über Iroh erreicht wird: Das Ticket ersetzt die Adresse, nicht die Prüfung. Eine Verbindung von Gerät zu Gerät hat kein JWT — das empfangende Gerät autorisiert den Anrufer selbst.
Gleiches Protokoll, beliebige Netzwerkform
Weil Sync auf verschlüsselten Einträgen arbeitet und überall dieselbe ContentAddressedStore-Schnittstelle nutzt, kann jeder Knoten am Sync teilnehmen, ohne Daten zu entschlüsseln. Ein Relay-Server speichert und leitet Einträge weiter, die er nicht lesen kann. Ein regionaler Cache liefert Einträge an nahe Clients aus, ohne Schlüssel zu brauchen. Die Vertrauensgrenze liegt auf Ebene der Schlüssel, nicht auf Ebene der Netzwerktopologie.
Standard-Deployment mit einem zentralen Server. Am einfachsten aufzusetzen und zu betreiben. Der Server prüft Benutzer über das Verzeichnis, speichert verschlüsselte Einträge und synchronisiert mit den verbundenen Clients. HTTP ist der Standard. Ein Server ohne öffentliche URL kann stattdessen auf Iroh lauschen und über ein iroh:-Ticket erreicht werden — ohne DynDNS, Portweiterleitung oder Zertifikat.
Zwei Geräte desselben Tenants synchronisieren direkt über Iroh (QUIC), ohne MindooDB-Server dazwischen. Native Clients versuchen zuerst einen direkten Weg und fallen sonst auf ein Relay zurück; ein Browser-Tab läuft nur über ein Relay. Das empfangende Gerät prüft Signaturen und Zugriffsregeln selbst, weil ein Peer keinen Witness-Receipt ausstellt. Dieselbe pullChangesFrom/pushChangesTo-API wie bei Client-Server.
Daten fließen durch Knoten, die sie nicht entschlüsseln können. Ein Krankenhausserver synchronisiert Patientenakten zwischen Kliniken, ohne sie zu lesen. Ein Passthrough-Knoten leitet Anfragen an einen Origin-Server weiter, etwa für Edge-Caching oder klare Zugriffsgrenzen.
| Topologie | Wann einsetzen | Benötigte Infrastruktur | Hauptvorteil |
|---|---|---|---|
| Client-Server | Standard-Einstieg; zuverlässiger Dauer-Sync | Ein Server + Clients (HTTP oder Iroh) | Einfachstes Deployment |
| Peer-to-Peer | Sync von Gerät zu Gerät, ohne MindooDB-Server dazwischen | Clients + Iroh (Relay, wenn NAT blockiert) | Kein Server im Pfad |
| Relay | Verteilung über nicht vertrauenswürdige Knoten | Relay-Server (ohne Schlüssel) | Sichere Datenverteilung |
| Store-Chain | Edge-Caching, geografische Verteilung | Origin + Edge-Knoten | Weniger Latenz |
| Mesh | Robuste Konvergenz über viele Peers | Mehrere Peers | Kein Single Point of Failure |
| Hybrid | Server für Zuverlässigkeit, Peers solange er ausfällt | Server + direkte Peer-Links | Das Beste aus beidem |
Crash-Sicherheit und Datenintegrität
MindooDB legt verschlüsselte, content-adressierte Einträge direkt im Dateisystem ab. Dadurch hat der Store die volle Kontrolle über Commit-Reihenfolge, Crash-Recovery und Deduplizierung, ohne auf eine eingebettete Datenbank-Engine wie SQLite oder LevelDB angewiesen zu sein.
Jeder Schreibvorgang folgt einem atomaren Ablauf: in eine temporäre Datei schreiben, fsync, atomar umbenennen, das übergeordnete Verzeichnis fsyncen. Lesende Zugriffe sehen nie einen halb geschriebenen Zustand. Die Commit-Reihenfolge (erst Payload, dann Metadaten, dann Index-Segment) stellt sicher, dass ein Eintrag erst auffindbar wird, wenn sein Payload sicher auf der Platte liegt.
- Crash zwischen Payload und Metadaten — Der verwaiste Payload ist harmlos
- Crash zwischen Metadaten und Index — Der Eintrag ist committet; der Index wird beim Start neu aufgebaut
- Crash während der Compaction — Ein veralteter Index wird erkannt und aus den maßgeblichen Eintragsdateien neu aufgebaut
Beim Start versucht der Store zuerst die schnelle Wiederherstellung: Metadaten-Snapshot laden, inkrementelle Segmente nachspielen, gegen die maßgeblichen Eintragsdateien validieren. Ist etwas veraltet oder inkonsistent, fällt er auf einen vollständigen Neuaufbau von der Platte zurück — transparent und ohne Datenverlust.
- In-Memory-Indizes — O(1)-Punktabfragen, Cursor-Scans per Binärsuche, dokumentbezogene Abfragen
- Segment-Compaction — Führt inkrementelle Metadaten zu frischen Snapshots zusammen und hält den Start schnell
- Source of Truth — Die Eintragsdateien auf der Platte sind immer maßgeblich; Indexdateien sind reine Beschleunigungsstrukturen und lassen sich gefahrlos löschen
Der vollständige Deep-Dive in die Implementierung steht in der Dokumentation zum On-Disk-Store.
Daten für Wachstum organisieren
Die Append-only-Architektur von MindooDB bedeutet, dass Daten über die Zeit anwachsen. Da jede Änderung für den Audit-Trail erhalten bleibt, lohnt es sich, dieses Wachstum einzuplanen. Das wichtigste Werkzeug ist Sharding auf Datenbankebene: Daten nach Zeitraum, Kategorie, Zugriffsstufe oder Region auf getrennte Datenbanken aufteilen. Jede Datenbank synchronisiert eigenständig, du steuerst also genau, welche Daten wohin fließen.
- Nach Zeit — Jahres- oder Monatsdatenbanken halten den Sync aktiver Daten schnell und bewahren die Historie
- Nach Kategorie — Getrennte Datenbanken je Dokumenttyp, Projekt oder Geschäftsbereich
- Nach Zugriff — Daten nach Schutzstufe trennen, damit Teams unterschiedliche Teilmengen synchronisieren
- Nach Region — Eine Datenbank pro Region für Anforderungen an den Datenstandort
Dokumente sind im Speicher verschlüsselt, serverseitige Abfragen sind damit ausgeschlossen. Stattdessen bietet MindooDB clientseitige inkrementelle Indexierung:
- Cursorbasierte Verarbeitung —
iterateChangesSince(cursor)verarbeitet nur Dokumente, die sich seit dem letzten Lauf geändert haben - Austauschbare Indexer — Änderungen an FlexSearch, Lunr oder einen eigenen Index weitergeben
- Virtuelle Ansichten — Tabellenartige, kategorisierte Ansichten mit Sortierung und Aggregation, über mehrere Datenbanken oder Tenants hinweg
Tenant-Isolation und tenant-übergreifende Zusammenarbeit
Tenants sind standardmäßig kryptografisch voneinander getrennt — jeder Tenant hat eigene Verschlüsselungsschlüssel, ein eigenes Benutzerverzeichnis und eigene Datenbanken. Tenant-übergreifende Zusammenarbeit ist möglich, indem einzelne Datenbanken oder benannte Verschlüsselungsschlüssel geteilt werden; die Administration bleibt dabei pro Tenant getrennt.
- Jeder Tenant hat eigene Verschlüsselungsschlüssel — keine gemeinsamen Geheimnisse
- Getrennte Benutzerverzeichnisse mit eigenen Admin-Schlüsseln
- Daten sind standardmäßig isoliert; Teilen erfordert eine explizite Schlüsselverteilung
- Der Widerruf eines Benutzers in einem Tenant wirkt sich nicht auf andere Tenants aus
- Einzelne Datenbanken über benannte Schlüssel zwischen Tenants teilen
- Virtuelle Ansichten können Daten über Tenant-Grenzen hinweg zusammenführen
- Jeder Tenant behält eigene Administration und eigenen Widerruf
- Nützlich für Lieferketten, Partnerorganisationen und gemeinsame Projekte
Was du vor der Einführung wissen solltest
Jede Architektur bringt Trade-offs mit sich. Die Ende-zu-Ende-Verschlüsselung und das Append-only-Design von MindooDB geben starke Garantien für Sicherheit und Nachvollziehbarkeit, bringen aber Einschränkungen mit, die du von Anfang an kennen solltest.
Wird ein Benutzer widerrufen, ist jeder weitere Sync blockiert und seine künftigen Änderungen werden abgelehnt. Bereits synchronisierte Daten auf seinem Gerät bleiben jedoch lesbar — kein System kann das Löschen auf einem Gerät garantieren, das sich nie wieder verbindet. Gegenmaßnahme: benannte Schlüssel für sensible Dokumente verwenden (kleinerer Wirkungsradius) und Schlüssel rotieren, wenn Benutzer das Team verlassen. Haven Enterprise ergänzt dieselben Governance-Policies um eine admin-signierte Remote-Löschung auf dem Gerät: Der Tenant wird von einem gestohlenen oder ausgemusterten Gerät entfernt, sobald es sich das nächste Mal verbindet.
Weil Daten verschlüsselt werden, bevor sie den Client verlassen, kann der Server keine Abfragen ausführen. Abgefragt wird ausschließlich clientseitig: über inkrementelle Indexierung, virtuelle Ansichten oder austauschbare Suchindexer. Das ist ein bewusster Trade-off — Vertraulichkeit vor serverseitigem Komfort.
Mehrere Schlüssel pro Benutzer (Signatur, Verschlüsselung, benannte symmetrische Schlüssel) müssen sicher verteilt werden. Gegenmaßnahme: Ein einziges Passwort entsperrt über eine KDF mit unterschiedlichen Salts alle Schlüssel. Der KeyBag bietet dafür einen einheitlichen Schlüsselspeicher. Der Join-Request/Response-Ablauf übernimmt den Schlüsselaustausch für neue Benutzer. Haven Enterprise automatisiert die laufende Arbeit: Admin-signierte Policies zur Schlüsselverteilung versorgen Benutzer und Gruppen mit Schlüsseln — und widerrufen sie wieder —, jeweils pro Empfänger verpackt, und jeder Client gleicht seinen KeyBag beim nächsten Sync ab.
Daten wachsen an, weil der Audit-Trail erhalten bleibt. Gegenmaßnahme: Sharding auf Datenbankebene begrenzt das Wachstum pro Sync-Einheit. CRDT-Snapshots senken die Kosten für das Nachspielen. Für regulatorisch erzwungene Löschungen steht die DSGVO-Bereinigung (purgeDocHistory) bereit.
MindooDB Haven setzt diese Bausteine in einer browserbasierten PWA um: Schlüssel bleiben beim Benutzer, Apps laufen capability-basiert im Sandkasten, dazu flexible Sync-Modi und eine echte App-Plattform. Schneller lässt sich MindooDB von Anfang bis Ende nicht erleben.