Conçue pour le zero trust, pensée pour la composabilité
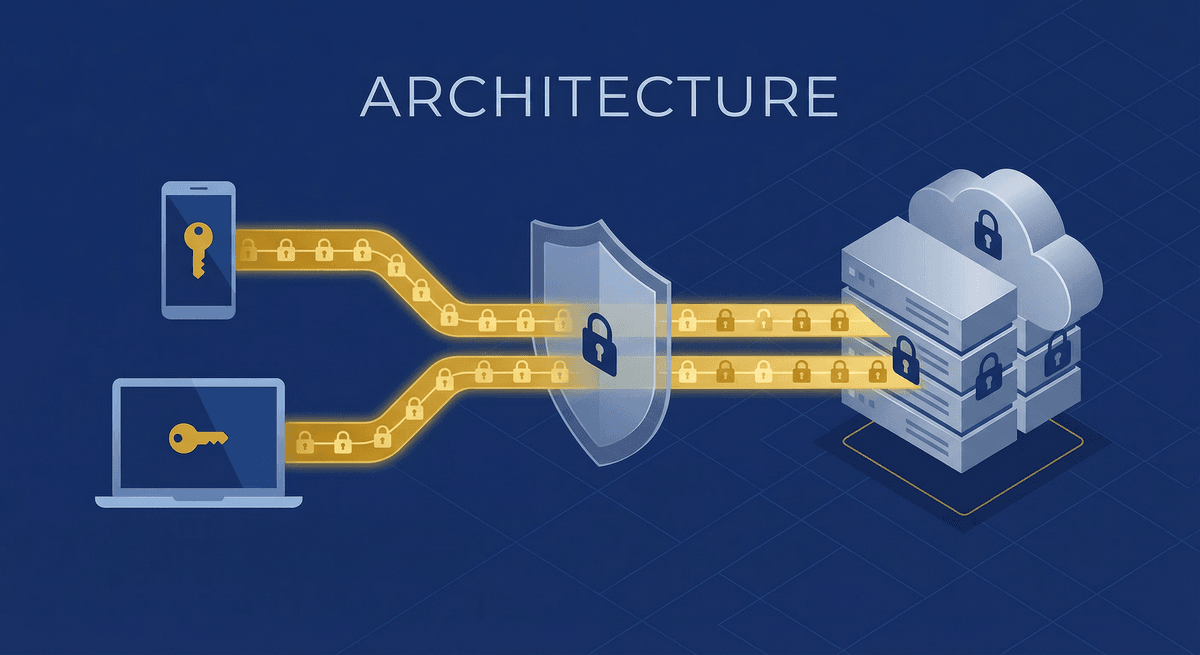
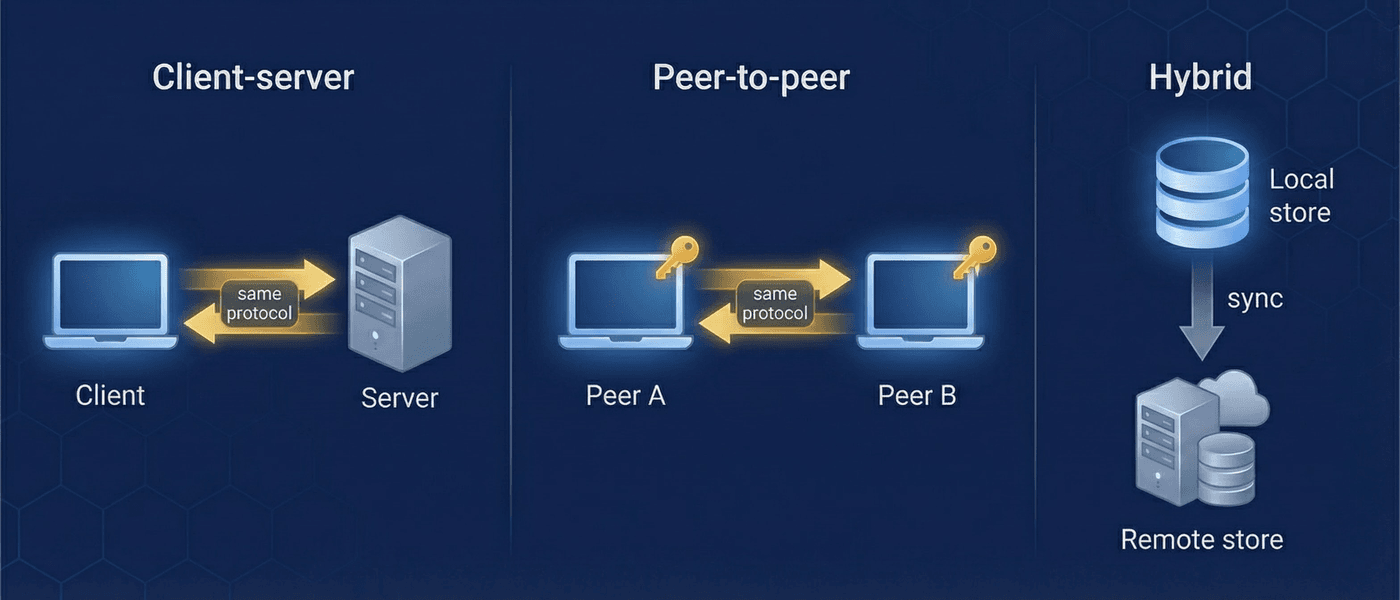
L'architecture de MindooDB sépare la synchronisation (transporter des octets chiffrés) de l'application (déchiffrer et interpréter les données). Ce seul choix de conception rend possibles les topologies client-serveur, peer-to-peer, relais et maillée — toutes avec le même protocole et le même code.
Ce que cette architecture vous apporte
Si vous évaluez MindooDB pour votre équipe, la question d'architecture décisive est : puis-je l'adopter par étapes, sans m'enfermer ? La réponse est oui. MindooDB est prévu pour une adoption progressive : commencer en local uniquement, ajouter la synchronisation client-serveur le moment venu, activer plus tard des topologies P2P ou relais. Chaque étape passe par la même interface ContentAddressedStore ; changer de modèle de déploiement relève donc de la configuration, pas d'une réécriture du code.
Quelques heures pour le mode local. Quelques jours pour la synchronisation client-serveur (2 endpoints d'authentification + 3 de synchronisation). Par étapes pour le P2P, les relais ou les optimisations par filtre de Bloom — sans changer le protocole.
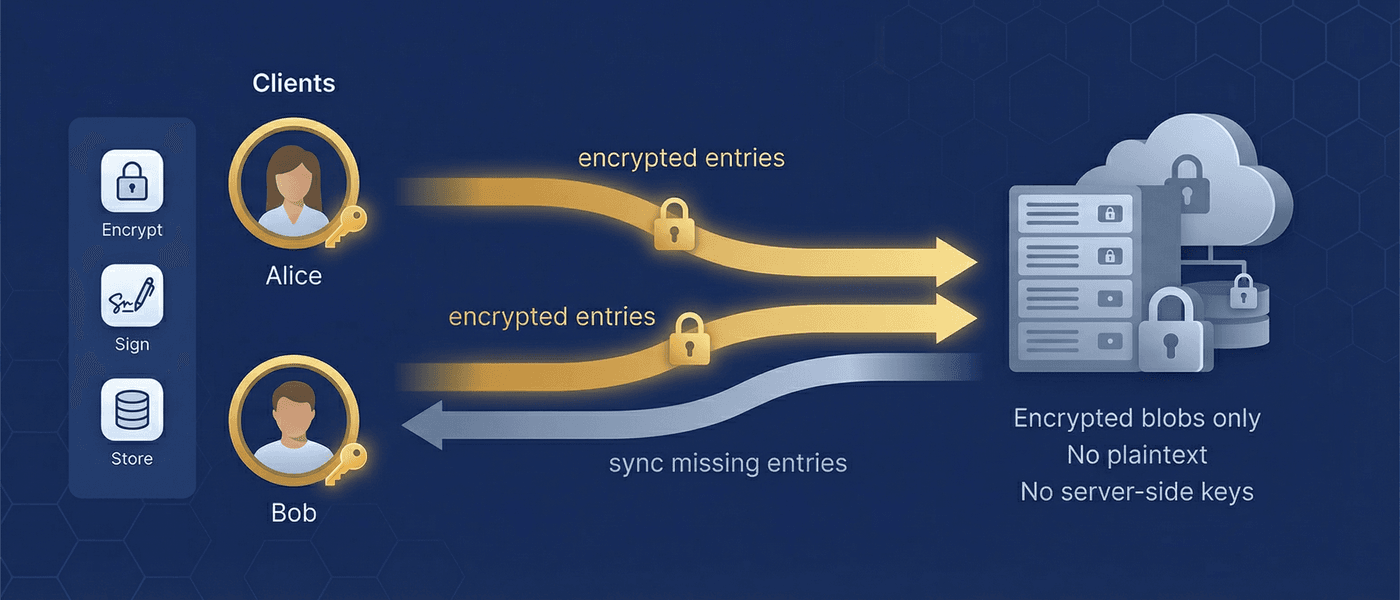
Trois couches de protection indépendantes : AES-256-GCM au repos, RSA par utilisateur en transit, TLS sur le réseau. Les serveurs ne voient jamais de texte en clair. Une compromission totale du serveur ne livre que du texte chiffré et des clés publiques.
Pas de comptes utilisateurs côté serveur, pas de mots de passe stockés, pas de base de sessions. Le serveur relaie des blobs chiffrés. La gestion des utilisateurs se fait côté client, via des paires de clés cryptographiques.
Tenants, utilisateurs et chaîne de confiance
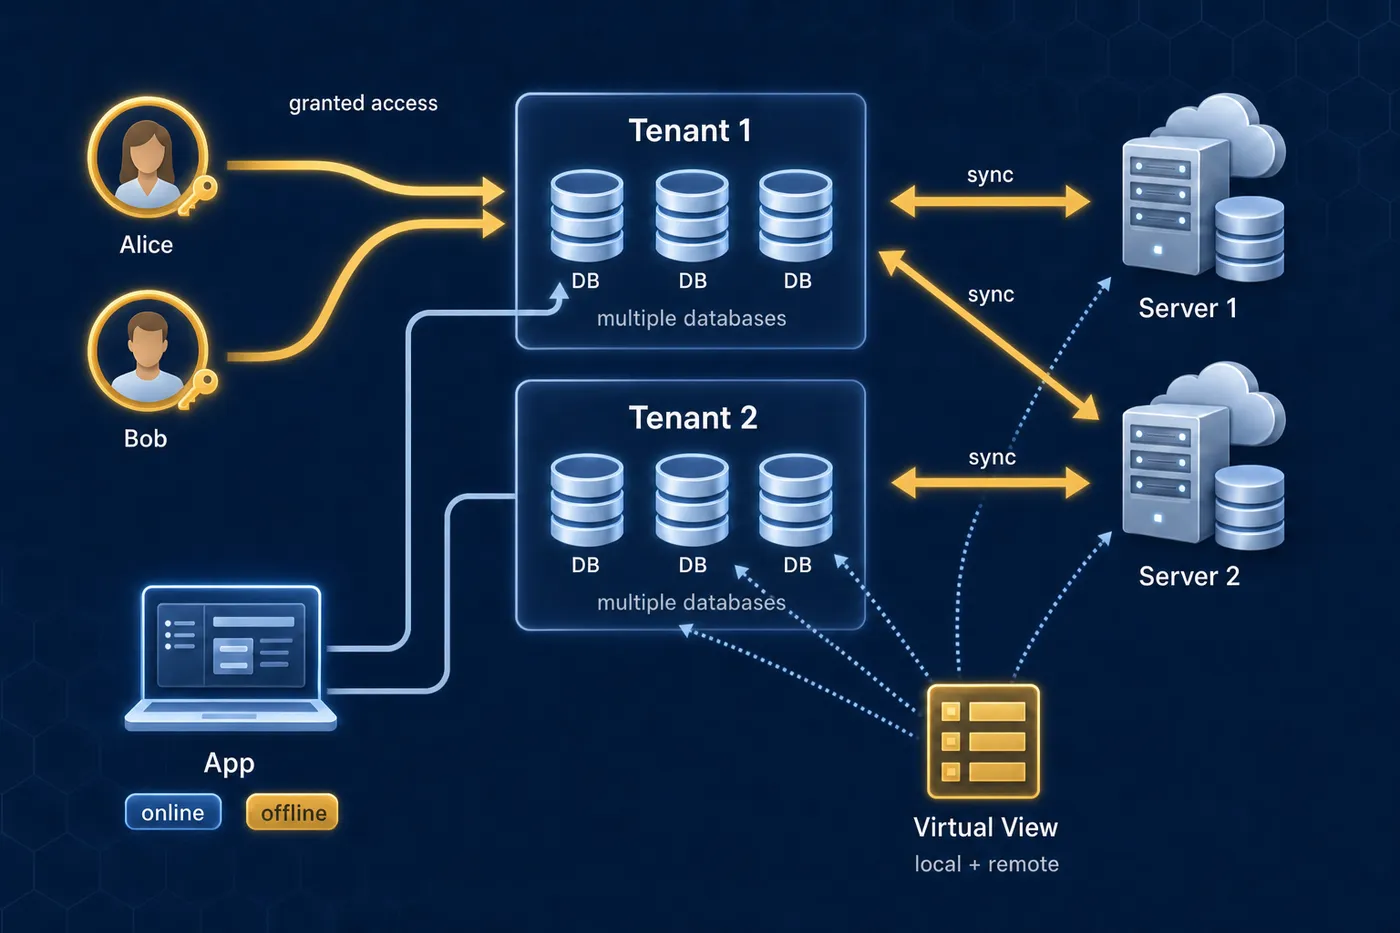
Un tenant MindooDB représente une organisation ou une équipe. Les tenants sont créés entièrement côté client : aucune inscription sur un serveur n'est nécessaire. Celui qui crée le tenant en devient l'administrateur, et sa clé de signature Ed25519 sert de racine de confiance. Chaque enregistrement d'utilisateur dans l'annuaire est signé avec cette clé d'administration, et clients comme serveurs vérifient ces signatures avant d'accorder leur confiance à la clé publique d'un utilisateur. La confiance repose donc sur des preuves cryptographiques, pas sur une authentification serveur.
Chaque tenant contient une base d'annuaire (registre des utilisateurs, réservé aux administrateurs), plusieurs bases applicatives et les clés qui contrôlent l'accès.
- Base d'annuaire — Enregistrements d'utilisateurs signés par l'admin, appartenances aux groupes, réglages
- Bases applicatives — Créées à la demande (
tenant.openDB("contacts")) - Documents — CRDT Automerge avec un historique signé, chiffré et append-only
- Pièces jointes — Stockage de fichiers découpé en blocs de 256 Ko, chiffré et dédupliqué
La confiance part de la clé d'administration, passe par l'annuaire et atteint les utilisateurs enregistrés. Chaque type de clé a un rôle précis :
- Clé de signature de l'admin (Ed25519) — Racine de confiance ; signe les entrées de l'annuaire
- Clé de chiffrement de l'admin (RSA-OAEP) — Chiffre les noms d'utilisateurs pour préserver la confidentialité
- Clés de signature des utilisateurs (Ed25519) — Prouvent qui est l'auteur d'une modification
- Clés de chiffrement des utilisateurs (RSA-OAEP) — Protègent le KeyBag stocké localement
- Clé de tenant par défaut (AES-256) — Chiffre les documents pour tous les membres
- Clés nommées (AES-256) — Accès fin réservé à certains utilisateurs
Le store adressé par contenu
Au centre de la souplesse de MindooDB se trouve l'interface ContentAddressedStore. Chaque store — adossé au disque local, à la mémoire ou à une connexion réseau distante — implémente cette même interface. Les méthodes de synchronisation pullChangesFrom() et pushChangesTo() acceptent n'importe quel ContentAddressedStore : elles fonctionnent donc de façon identique, que l'autre côté soit un store local, un serveur distant en HTTP ou via Iroh, ou un autre client connecté via Iroh.
C'est cette idée de conception qui rend toutes les topologies possibles : parce que les stores réseau implémentent la même interface que les stores locaux, la synchronisation devient composable. Le store sous-jacent d'un serveur peut lui-même être un store distant (chaînage de stores). Un relais peut transmettre des entrées chiffrées sans les déchiffrer. Un pair peut exécuter la même logique de synchronisation qu'un serveur. La topologie est une décision de déploiement, pas une modification du code.
Chaque modification de document, chaque snapshot et chaque bloc de pièce jointe est stocké comme une entrée immuable, avec un identifiant unique et un hachage de contenu. Les entrées ne sont jamais modifiées ni supprimées, ce qui garantit une piste d'audit complète.
Chaque entrée référence ses entrées parentes par identifiant (ce qui forme un DAG) et est signée par son auteur. Altérer une entrée casse la chaîne : l'intégrité est vérifiable en tout point.
Les entrées sont identifiées par id et dédupliquées par contentHash (SHA-256 du payload chiffré). Un contenu identique venu de plusieurs sources n'est stocké qu'une fois.
Commencer simple, optimiser ensuite
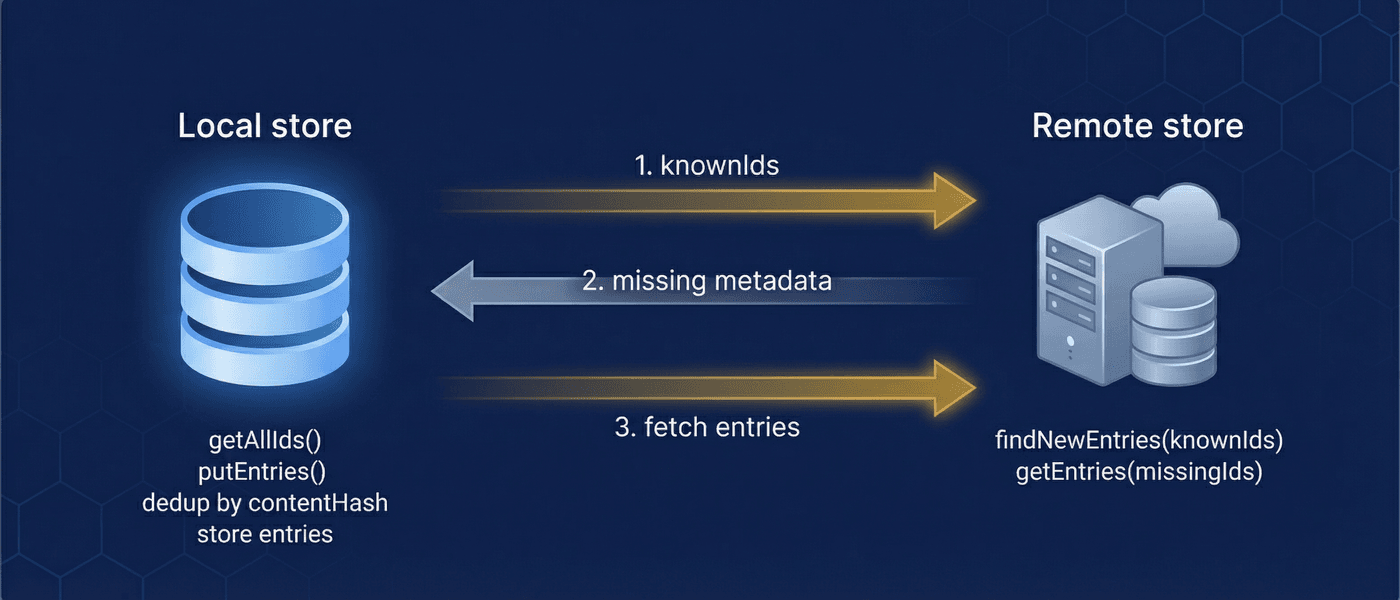
Le protocole de synchronisation propose trois voies qui partagent les mêmes endpoints et le même modèle d'entrées. La synchronisation de base est la plus simple : envoyer les identifiants d'entrées connus, recevoir les métadonnées de ce qui manque, récupérer ces entrées. Elle convient à n'importe quel volume de données et reste le point de départ recommandé. La synchronisation optimisée ajoute le parcours par curseur et les résumés par filtre de Bloom pour les gros volumes ; les deux sont négociés à l'exécution par découverte de capacités et restent donc transparents pour le code applicatif. La synchronisation dense s'appuie sur le planificateur de matérialisation causale et ne transfère que les entrées nécessaires à l'état actuel du document — le meilleur snapshot et les modifications qu'il ne couvre pas — en laissant de côté l'historique et en reportant les pièces jointes. Idéale pour une première installation mobile sur une connexion à faible bande passante.
Ces invariants valent pour toutes les topologies de déploiement — client-serveur, P2P, chaînes de relais et maillage :
- Complétude — Après un cycle de synchronisation complet, le client connaît les métadonnées de chaque entrée distante
- Idempotence — Chaque endpoint peut être appelé plusieurs fois sans effet de bord
- Indépendance à l'ordre — Les entrées peuvent arriver dans n'importe quel ordre ; les CRDT assurent la convergence
- Déduplication — Des entrées identiques venues de plusieurs sources ne sont stockées qu'une fois
Au-delà de quelques dizaines de milliers d'entrées, ces techniques gardent la synchronisation rapide :
- Parcours par curseur — Parcourir les métadonnées distantes page par page au lieu d'envoyer de longues listes d'identifiants. La taille de la requête reste constante, quelle que soit celle du store.
- Résumé par filtre de Bloom — Télécharger une représentation probabiliste compacte de l'ensemble pour préfiltrer les identifiants. Élimine 90 à 99 % des vérifications d'existence exactes.
- Snapshots CRDT — Des snapshots réguliers évitent que le rejeu de longs historiques de documents dégrade les performances.
- Synchronisation dense — Ne transférer que le dernier snapshot et les modifications non couvertes de chaque document, sans historique ni pièces jointes. En savoir plus →
Chaque opération de synchronisation exige une authentification par challenge-response : le client signe avec sa clé Ed25519 un challenge généré par le serveur, qui émet en retour un JWT de courte durée. La révocation s'applique à deux endroits — à la génération du challenge et à la validation du jeton — si bien qu'un utilisateur révoqué est exclu immédiatement, même en pleine session. Aucun mot de passe ni jeton n'est stocké sur le serveur. Le même défi et le même JWT s'appliquent lorsque le serveur est joint via Iroh : le ticket remplace l'adresse, pas le contrôle. Un lien d'appareil à appareil n'a pas de JWT — l'appareil qui reçoit autorise lui-même l'appelant.
Même protocole, n'importe quelle forme de réseau
Parce que la synchronisation travaille sur des entrées chiffrées et utilise partout la même interface ContentAddressedStore, n'importe quel nœud peut y participer sans déchiffrer les données. Un serveur relais stocke et transmet des entrées qu'il ne peut pas lire. Un cache régional sert des entrées aux clients proches sans détenir de clé. La frontière de confiance se situe au niveau des clés de chiffrement, pas au niveau de la topologie réseau.
Déploiement standard avec un serveur central. Le plus simple à mettre en place et à exploiter. Le serveur valide les utilisateurs via l'annuaire, stocke les entrées chiffrées et se synchronise avec les clients connectés. HTTP est le défaut. Un serveur sans URL publique peut à la place écouter sur Iroh et se joindre avec un ticket iroh: — sans DynDNS, redirection de port ni certificat.
Deux appareils du même tenant se synchronisent directement via Iroh (QUIC), sans serveur MindooDB entre les deux. Les clients natifs tentent d'abord un chemin direct, puis basculent sur un relais ; un onglet de navigateur passe toujours par un relais. L'appareil qui reçoit vérifie lui-même les signatures et les règles d'accès, car un pair n'émet pas de reçu de témoin. Même API pullChangesFrom/pushChangesTo qu'en client-serveur.
Les données transitent par des nœuds qui ne peuvent pas les déchiffrer. Un serveur hospitalier synchronise des dossiers patients entre cliniques sans les lire. Un nœud de transit relaie les requêtes vers un serveur d'origine, pour du cache en périphérie ou pour poser une frontière d'accès.
| Topologie | Quand l'utiliser | Infrastructure nécessaire | Atout principal |
|---|---|---|---|
| Client-serveur | Point de départ par défaut ; synchronisation continue et fiable | Un serveur + des clients (HTTP ou Iroh) | Déploiement le plus simple |
| Peer-to-peer | Synchronisation d'appareil à appareil, sans serveur MindooDB dans le chemin | Clients + Iroh (relais si le NAT bloque) | Pas de serveur dans le chemin |
| Relais | Diffusion via des nœuds non fiables | Serveur relais (sans clés) | Diffusion sécurisée des données |
| Chaîne de stores | Cache en périphérie, répartition géographique | Origine + nœuds de périphérie | Latence réduite |
| Maillage | Convergence robuste entre plusieurs pairs | Plusieurs pairs | Aucun point de défaillance unique |
| Hybride | Serveur pour la fiabilité, pairs pendant qu'il est arrêté | Serveur + liens directs entre pairs | Le meilleur des deux |
Résistance aux pannes et intégrité des données
MindooDB écrit ses entrées chiffrées et adressées par contenu directement sur le système de fichiers. Le store garde ainsi la maîtrise complète de l'ordre des commits, de la reprise après panne et de la déduplication, sans dépendre d'un moteur de base embarqué comme SQLite ou LevelDB.
Chaque écriture de fichier suit un protocole atomique : écrire dans un fichier temporaire, fsync, renommage atomique, fsync du répertoire parent. Les lecteurs ne voient jamais un état à moitié écrit. L'ordre des commits (d'abord le payload, puis les métadonnées, puis le segment d'index) garantit qu'une entrée ne devient visible qu'une fois son payload bien écrit sur le disque.
- Panne entre le payload et les métadonnées — Le payload orphelin est sans conséquence
- Panne entre les métadonnées et l'index — L'entrée est validée ; l'index est reconstruit au démarrage
- Panne pendant une compaction — L'index obsolète est détecté et reconstruit à partir des fichiers d'entrées faisant foi
Au démarrage, le store tente d'abord la reprise rapide : charger le snapshot de métadonnées, rejouer les segments incrémentaux et valider le tout contre les fichiers d'entrées faisant foi. Si quelque chose est obsolète ou incohérent, il bascule sur une reconstruction complète depuis le disque — de façon transparente et sans perte de données.
- Index en mémoire — Accès ponctuel en O(1), parcours par curseur en recherche binaire, requêtes limitées à un document
- Compaction des segments — Fusionne les métadonnées incrémentales dans de nouveaux snapshots pour garder un démarrage rapide
- Source de vérité — Les fichiers d'entrées sur le disque font toujours foi ; les fichiers d'index ne sont que des structures d'accélération, supprimables sans risque
Le détail complet de la mise en œuvre est décrit dans la documentation du store sur disque.
Organiser les données pour la croissance
L'architecture append-only de MindooDB fait que les données s'accumulent avec le temps. Comme chaque modification est conservée pour la piste d'audit, il est important d'anticiper cette croissance. L'outil principal est le sharding au niveau des bases de données : répartir les données dans des bases distinctes par période, catégorie, niveau d'accès ou région. Chaque base se synchronise indépendamment, vous contrôlez donc précisément quelles données circulent où.
- Par période — Des bases annuelles ou mensuelles gardent la synchronisation rapide sur les données actives tout en conservant l'historique
- Par catégorie — Des bases distinctes par type de document, projet ou entité
- Par niveau d'accès — Isoler les données par niveau de confidentialité pour que chaque équipe synchronise son sous-ensemble
- Par région — Une base par région, pour les exigences de localisation des données
Les documents sont chiffrés au repos : les requêtes côté serveur sont donc impossibles. MindooDB propose à la place une indexation incrémentale côté client :
- Traitement par curseur —
iterateChangesSince(cursor)ne traite que les documents modifiés depuis le dernier passage - Indexeurs interchangeables — Alimenter FlexSearch, Lunr ou n'importe quel index maison avec les modifications
- Vues virtuelles — Catégorisation, tri et agrégation façon tableur, couvrant plusieurs bases de données ou tenants
Isolation des tenants et collaboration entre tenants
Les tenants sont par défaut isolés cryptographiquement : chacun dispose de ses propres clés de chiffrement, de son propre annuaire d'utilisateurs et de son propre jeu de bases de données. La collaboration entre tenants passe par le partage de bases précises ou de clés de chiffrement nommées, chaque tenant gardant son administration indépendante.
- Chaque tenant a ses propres clés de chiffrement — aucun secret partagé
- Des annuaires d'utilisateurs séparés, avec des clés d'administration distinctes
- Données isolées par défaut ; tout partage exige une distribution de clés explicite
- Révoquer un utilisateur dans un tenant n'a aucun effet sur les autres tenants
- Partager des bases de données précises entre tenants à l'aide de clés nommées
- Les vues virtuelles peuvent agréger des données par-delà les frontières des tenants
- Chaque tenant garde son administration et sa révocation propres
- Utile pour les chaînes d'approvisionnement, les organisations partenaires et les projets communs
Ce qu'il faut savoir avant d'adopter
Toute architecture implique des compromis. Le chiffrement de bout en bout et la conception append-only de MindooDB offrent de solides garanties de sécurité et de traçabilité, mais ils imposent des contraintes à connaître dès le départ.
Révoquer un utilisateur bloque toute synchronisation ultérieure et rejette ses futures modifications. En revanche, les données déjà synchronisées sur son appareil restent accessibles : aucun système ne peut garantir une suppression sur un appareil qui ne se reconnecte jamais. Parade : utiliser des clés nommées pour les documents sensibles (rayon d'impact plus petit) et faire tourner les clés au départ d'un utilisateur. Haven Enterprise ajoute aux mêmes politiques de gouvernance un effacement à distance signé par l'admin : le tenant est retiré d'un appareil volé ou d'un utilisateur parti dès sa prochaine connexion.
Comme les données sont chiffrées avant de quitter le client, le serveur ne peut exécuter aucune requête. Tout passe par le client : indexation incrémentale, vues virtuelles ou indexeurs de recherche interchangeables. C'est un compromis délibéré — la confidentialité plutôt que le confort côté serveur.
Plusieurs clés par utilisateur (signature, chiffrement, clés symétriques nommées) doivent être distribuées de façon sûre. Parade : un seul mot de passe déverrouille toutes les clés, via une KDF et des sels différents. Le KeyBag offre un stockage de clés unifié. Le flux de demande/réponse d'adhésion prend en charge l'échange de clés pour les nouveaux utilisateurs. Haven Enterprise automatise le travail courant : des politiques de distribution de clés signées par l'admin provisionnent les clés aux utilisateurs et aux groupes — et les retirent —, chacune encapsulée pour son destinataire, et chaque client met son KeyBag à jour à la synchronisation suivante.
Les données s'accumulent parce que la piste d'audit est conservée. Parade : le sharding au niveau des bases limite la croissance par unité de synchronisation. Les snapshots CRDT réduisent le coût du rejeu. La purge RGPD (purgeDocHistory) est disponible lorsqu'une suppression réglementaire s'impose.
MindooDB Haven met ces primitives en œuvre dans une PWA qui tourne dans le navigateur : clés détenues par le client, isolation des apps fondée sur les capacités, modes de synchronisation flexibles et véritable plateforme applicative. C'est le moyen le plus rapide de découvrir MindooDB de bout en bout.