Costruita per lo zero trust, progettata per la componibilità
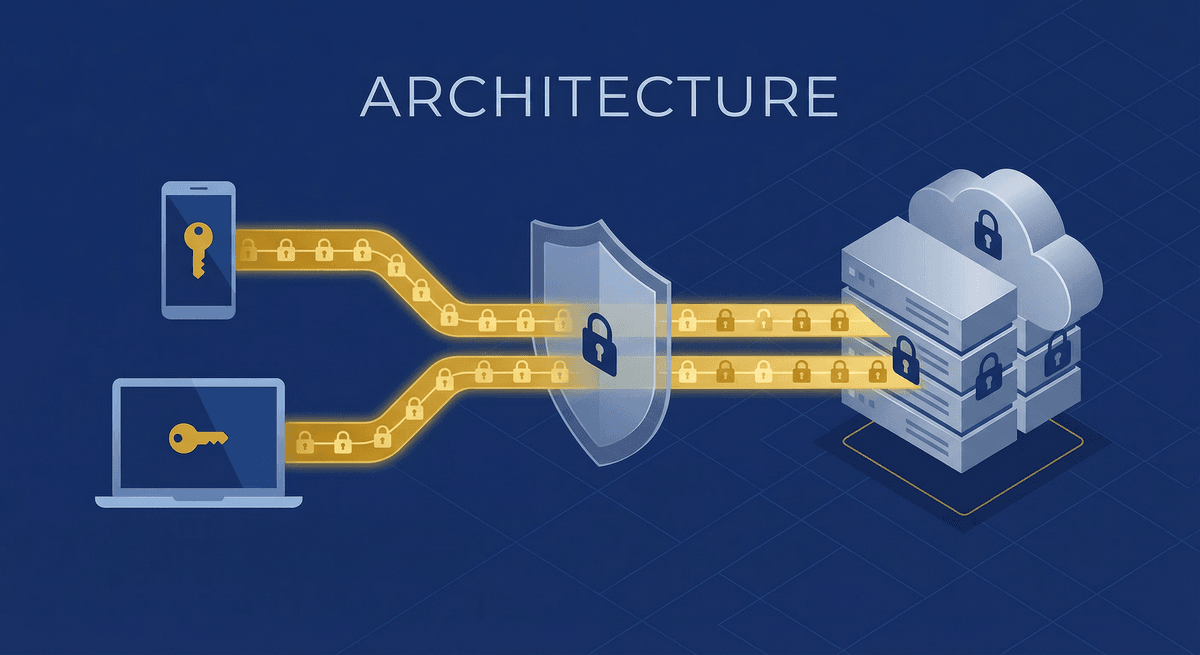
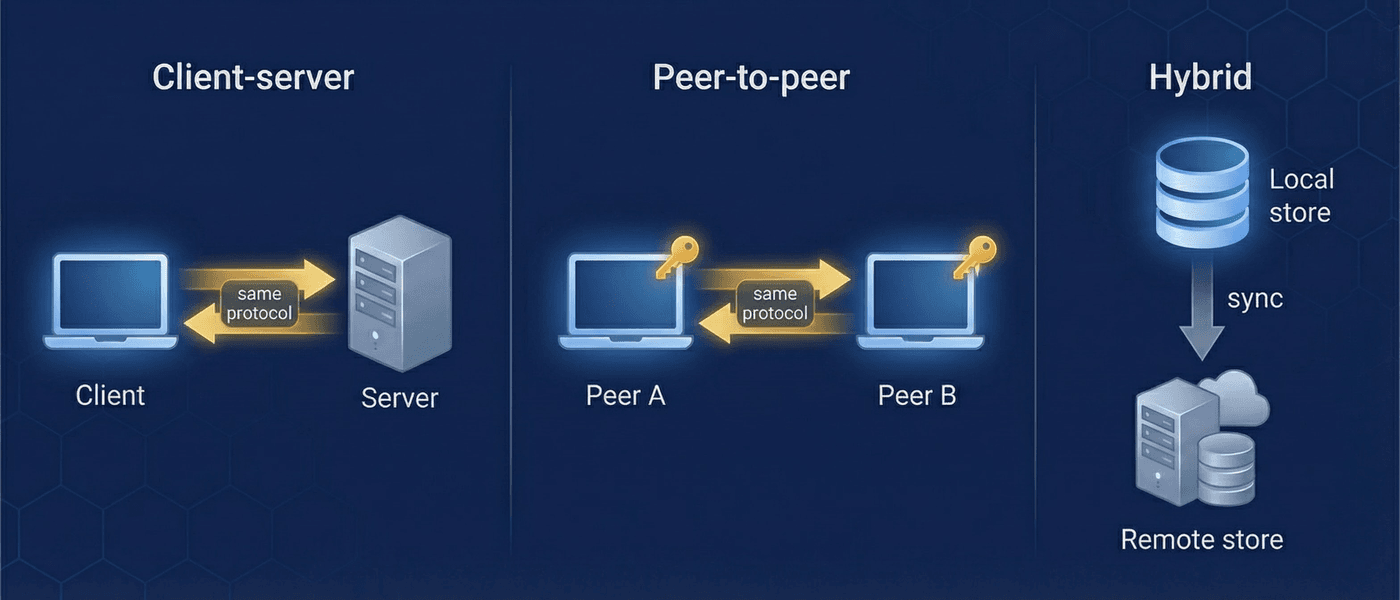
L'architettura di MindooDB separa il compito della sincronizzazione (trasportare byte cifrati) da quello dell'applicazione (decifrare e interpretare i dati). Questa singola scelta di progetto rende possibili topologie client-server, peer-to-peer, relay e mesh — tutte con lo stesso protocollo e lo stesso codice.
Che cosa ti offre questa architettura
Se stai valutando MindooDB per il tuo team, la domanda architetturale decisiva è: posso adottarlo passo a passo senza lock-in? La risposta è sì. MindooDB è pensato per un'adozione progressiva: parti in locale, aggiungi la sincronizzazione client-server quando ti serve, attiva più tardi le topologie P2P o relay. Ogni passo usa la stessa interfaccia ContentAddressedStore, quindi cambiare modello di deployment è una decisione di configurazione, non una riscrittura del codice.
Ore per il solo uso locale. Giorni per la sincronizzazione client-server (2 endpoint di autenticazione + 3 di sincronizzazione). Passo a passo per P2P, relay o ottimizzazioni con filtro di Bloom — senza modifiche al protocollo.
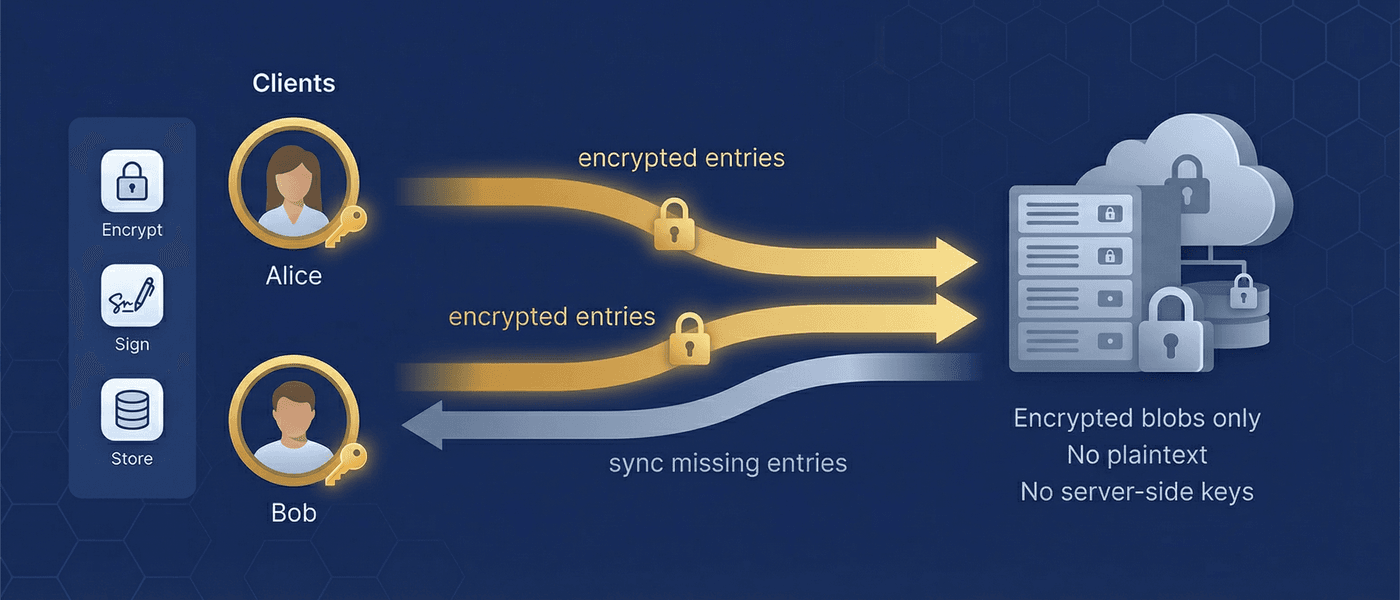
Tre livelli di protezione indipendenti: AES-256-GCM a riposo, RSA per utente in transito, TLS sulla linea. I server non vedono mai il testo in chiaro. Una violazione completa del server restituisce solo testo cifrato e chiavi pubbliche.
Nessun account utente lato server, nessuna password archiviata, nessun database di sessioni. Il server è un relay per blob cifrati. La gestione degli utenti avviene lato client, tramite coppie di chiavi crittografiche.
Tenant, utenti e catena di fiducia
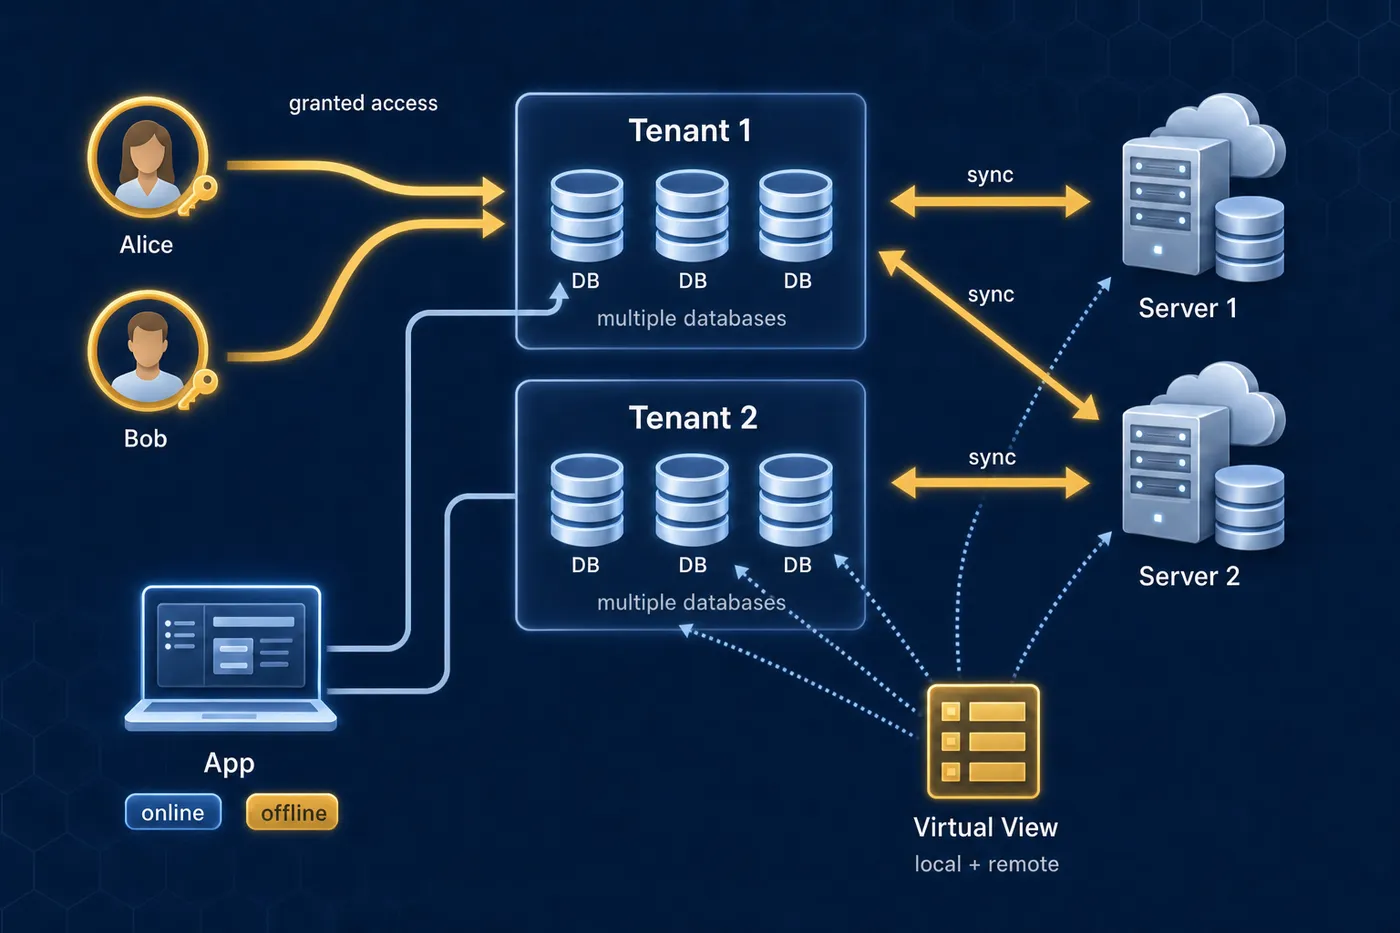
Un tenant MindooDB rappresenta un'organizzazione o un team. I tenant nascono interamente lato client, senza alcuna registrazione sul server. Chi crea il tenant ne diventa l'amministratore e la sua chiave di firma Ed25519 è la radice di fiducia. Ogni registrazione di utente nella directory è firmata con questa chiave di admin, e client e server verificano queste firme prima di fidarsi della chiave pubblica di un utente. La fiducia nasce quindi da prove crittografiche, non da un'autenticazione sul server.
Ogni tenant contiene un database directory (il registro degli utenti, solo per admin), più database applicativi e le chiavi che regolano l'accesso.
- Database directory — Registrazioni di utenti firmate dall'admin, appartenenze ai gruppi, impostazioni
- Database applicativi — Creati su richiesta (
tenant.openDB("contacts")) - Documenti — CRDT Automerge con cronologia firmata, cifrata e append-only
- Allegati — Archiviazione di file in chunk (256 KB), cifrata e deduplicata
La fiducia scorre dalla chiave di admin attraverso la directory fino agli utenti registrati. Ogni tipo di chiave ha uno scopo preciso:
- Chiave di firma dell'admin (Ed25519) — Radice di fiducia; firma le voci della directory
- Chiave di crittografia dell'admin (RSA-OAEP) — Cifra i nomi utente per tutelare la privacy
- Chiavi di firma degli utenti (Ed25519) — Dimostrano la paternità delle modifiche ai documenti
- Chiavi di crittografia degli utenti (RSA-OAEP) — Proteggono il KeyBag salvato in locale
- Chiave predefinita del tenant (AES-256) — Cifra i documenti per tutti i membri
- Chiavi con nome (AES-256) — Accesso granulare per utenti specifici
Lo store content-addressed
Al centro della flessibilità di MindooDB c'è l'interfaccia ContentAddressedStore. Ogni store — su disco locale, in memoria o dietro una connessione di rete — implementa la stessa interfaccia. I metodi di sincronizzazione pullChangesFrom() e pushChangesTo() accettano qualsiasi ContentAddressedStore e funzionano quindi in modo identico, sia che la controparte sia uno store locale, un server remoto via HTTP o Iroh, o un altro client collegato via Iroh.
È questa l'idea di progetto che rende possibile ogni topologia: poiché gli store di rete implementano la stessa interfaccia di quelli locali, la sincronizzazione diventa componibile. Lo store di appoggio di un server può essere a sua volta uno store remoto (store chaining). Un relay può inoltrare voci cifrate senza decifrarle. Un peer può eseguire la stessa logica di sincronizzazione di un server. La topologia è una decisione di deployment, non una modifica al codice.
Ogni modifica a un documento, ogni snapshot e ogni chunk di allegato è salvato come voce immutabile, con un ID univoco e un hash del contenuto. Le voci non vengono mai modificate né eliminate: così l'audit trail resta completo.
Ogni voce fa riferimento per ID alle voci che la precedono (formando un DAG) ed è firmata da chi l'ha creata. Manomettere una voce rompe la catena: l'integrità è verificabile in qualsiasi punto.
Le voci sono identificate da id e deduplicate in base a contentHash (SHA-256 del payload cifrato). Contenuti identici provenienti da più fonti vengono archiviati una volta sola.
Parti semplice, ottimizza dopo
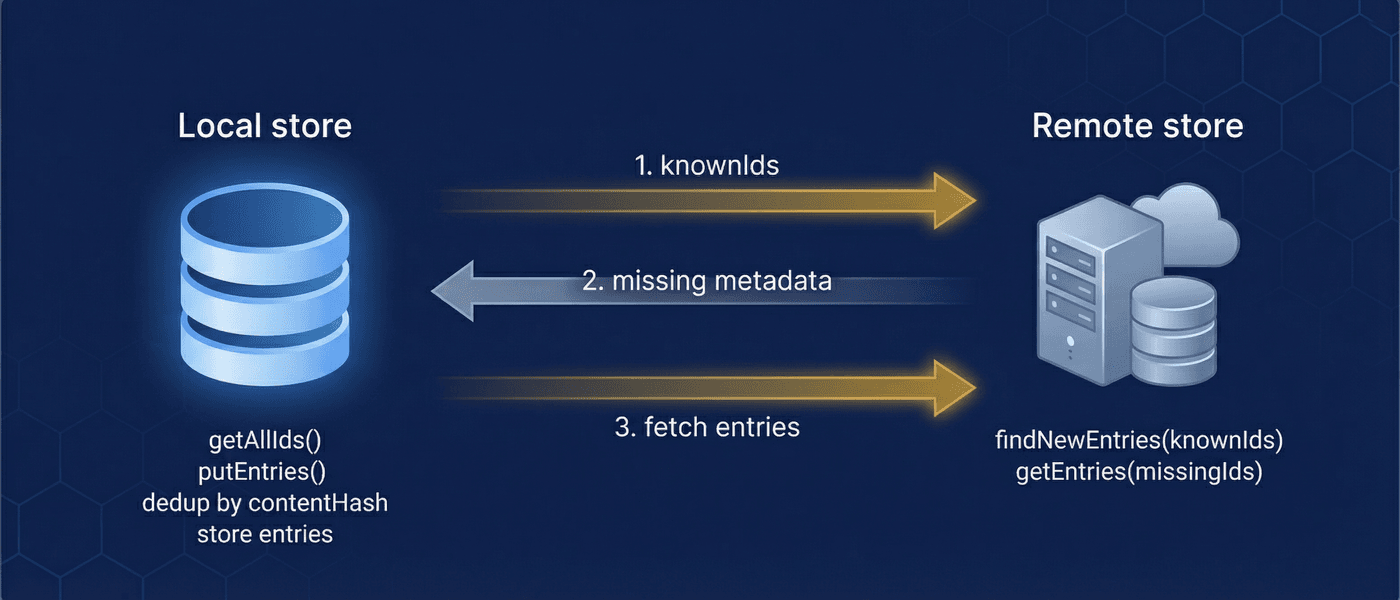
Il protocollo di sincronizzazione offre tre percorsi che condividono gli stessi endpoint e lo stesso modello di voci. La sincronizzazione baseline è la più semplice: invii gli ID delle voci che conosci, ricevi i metadati di quelle che ti mancano e le recuperi. Funziona con qualsiasi volume di dati ed è il punto di partenza consigliato. La sincronizzazione ottimizzata aggiunge la scansione a cursore e i riepiloghi con filtro di Bloom per volumi maggiori: entrambi vengono negoziati a runtime tramite la capability discovery e sono quindi trasparenti per il codice applicativo. La dense sync usa il pianificatore di materializzazione causale e trasferisce solo le voci necessarie allo stato attuale del documento — lo snapshot migliore più le modifiche che non copre — lasciando fuori le voci storiche e rinviando gli allegati. Ideale per la prima configurazione su mobile, con banda limitata.
Queste invarianti valgono in tutte le topologie di deployment: client-server, P2P, catene di relay e mesh:
- Completezza — Dopo un ciclo completo di sincronizzazione il client conosce i metadati di ogni voce remota
- Idempotenza — Ogni endpoint può essere chiamato più volte senza effetti collaterali
- Indipendenza dall'ordine — Le voci possono arrivare in qualsiasi sequenza; alla convergenza pensano i CRDT
- Deduplicazione — Voci identiche da più fonti vengono archiviate una volta sola
Oltre le decine di migliaia di voci, due tecniche mantengono veloce la sincronizzazione:
- Scansione a cursore — Scorre i metadati remoti pagina per pagina, invece di inviare lunghi elenchi di ID. La dimensione della richiesta resta costante, indipendentemente dalle dimensioni dello store.
- Riepilogo con filtro di Bloom — Scarica una rappresentazione probabilistica compatta dell'insieme per prefiltrare gli ID. Elimina il 90-99% dei controlli esatti di esistenza.
- Snapshot CRDT — Snapshot periodici evitano il calo di prestazioni dovuto alla riesecuzione di cronologie di documenti molto lunghe.
- Dense sync — Trasferisce solo lo snapshot più recente e le modifiche che non copre, documento per documento, senza cronologia né allegati. Scopri di più →
Ogni operazione di sincronizzazione richiede un'autenticazione challenge-response: il client firma con la propria chiave Ed25519 una challenge generata dal server, e il server emette un JWT di breve durata. La revoca agisce in due punti — alla generazione della challenge e alla convalida del token — quindi un utente revocato è escluso subito, anche a sessione in corso. Sul server non vengono archiviate né password né token. La stessa challenge e lo stesso JWT valgono quando il server si raggiunge via Iroh: il ticket sostituisce l'indirizzo, non il controllo. Un collegamento da dispositivo a dispositivo non ha un JWT — il dispositivo che riceve autorizza da sé chi chiama.
Stesso protocollo, qualsiasi forma di rete
Poiché la sincronizzazione lavora su voci cifrate e usa sempre la stessa interfaccia ContentAddressedStore, qualsiasi nodo può parteciparvi senza decifrare i dati. Un server relay archivia e inoltra voci che non può leggere. Una cache regionale serve voci ai client vicini senza avere bisogno delle chiavi. Il confine di fiducia sta al livello delle chiavi di crittografia, non a quello della topologia di rete.
Deployment standard con un server centrale. È il più semplice da allestire e da gestire. Il server convalida gli utenti tramite la directory, archivia le voci cifrate e si sincronizza con i client collegati. HTTP è il default. Un server senza URL pubblica può invece restare in ascolto su Iroh e raggiungersi con un ticket iroh: — senza DynDNS, inoltro di porta o certificato.
Due dispositivi dello stesso tenant si sincronizzano direttamente via Iroh (QUIC), senza un server MindooDB in mezzo. I client nativi tentano prima un percorso diretto e altrimenti ricadono su un relay; una scheda del browser passa sempre da un relay. Il dispositivo che riceve verifica da sé firme e regole di accesso, perché un peer non emette una ricevuta di testimone. Stessa API pullChangesFrom/pushChangesTo del client-server.
I dati passano attraverso nodi che non possono decifrarli. Il server di un ospedale sincronizza le cartelle dei pazienti tra le cliniche senza leggerle. Un nodo passthrough inoltra le richieste a un server di origine, per il caching all'edge o per separare gli ambiti di accesso.
| Topologia | Quando usarla | Infrastruttura necessaria | Vantaggio principale |
|---|---|---|---|
| Client-server | Punto di partenza predefinito; sincronizzazione sempre attiva | Un server + client (HTTP o Iroh) | Deployment più semplice |
| Peer-to-peer | Sincronizzazione da dispositivo a dispositivo, senza server MindooDB nel percorso | Client + Iroh (relay se il NAT blocca) | Nessun server nel percorso |
| Relay | Distribuzione di dati tramite nodi non fidati | Server relay (senza chiavi) | Distribuzione sicura dei dati |
| Store chain | Caching all'edge, distribuzione geografica | Origine + nodi edge | Meno latenza |
| Mesh | Convergenza robusta tra più peer | Più peer | Nessun single point of failure |
| Ibrida | Server per l'affidabilità, peer mentre è fermo | Server + collegamenti diretti tra peer | Il meglio dei due mondi |
Sicurezza in caso di crash e integrità dei dati
MindooDB salva voci cifrate e content-addressed direttamente sul filesystem. Così lo store controlla per intero l'ordine dei commit, il ripristino dopo un crash e la deduplicazione, senza dipendere da un motore di database incorporato come SQLite o LevelDB.
Ogni scrittura su file segue un protocollo atomico: scrittura su file temporaneo, fsync, rinomina atomica, fsync della directory superiore. Chi legge non vede mai uno stato scritto a metà. L'ordine dei commit (prima il payload, poi i metadati, poi il segmento di indice) garantisce che una voce diventi rintracciabile solo quando il suo payload è già al sicuro sul disco.
- Crash tra payload e metadati — Il payload orfano è innocuo
- Crash tra metadati e indice — La voce è committata; l'indice viene ricostruito all'avvio
- Crash durante la compattazione — L'indice obsoleto viene rilevato e ricostruito dai file delle voci, che fanno fede
All'avvio lo store tenta prima il ripristino rapido: carica lo snapshot dei metadati, riapplica i segmenti incrementali e li convalida contro i file delle voci, che fanno fede. Se qualcosa è obsoleto o incoerente, ricade su una ricostruzione completa dal disco, in modo trasparente e senza perdita di dati.
- Indici in memoria — Ricerche puntuali in O(1), scansioni a cursore con ricerca binaria, query limitate a un documento
- Compattazione dei segmenti — Unisce i metadati incrementali in nuovi snapshot, per mantenere veloce l'avvio
- Fonte di verità — I file delle voci sul disco fanno sempre fede; i file di indice sono strutture di accelerazione e si possono eliminare senza rischi
Per un approfondimento completo dell'implementazione, vedi la documentazione dello store su disco.
Organizzare i dati in vista della crescita
L'architettura append-only di MindooDB comporta che i dati si accumulino nel tempo. Poiché ogni modifica viene conservata per l'audit trail, vale la pena pianificare questa crescita. Lo strumento principale è lo sharding a livello di database: dividere i dati in database separati per periodo, categoria, livello di accesso o area geografica. Ogni database si sincronizza per conto proprio, quindi controlli esattamente quali dati vanno dove.
- Per periodo — Database annuali o mensili mantengono veloce la sincronizzazione dei dati attivi e conservano la cronologia
- Per categoria — Database separati per tipo di documento, progetto o unità organizzativa
- Per accesso — Dati isolati per livello di sicurezza, così team diversi sincronizzano sottoinsiemi diversi
- Per area geografica — Un database per regione, per i requisiti di residenza dei dati
I documenti sono cifrati a riposo, quindi le query lato server non sono possibili. MindooDB offre invece un'indicizzazione incrementale lato client:
- Elaborazione a cursore —
iterateChangesSince(cursor)elabora solo i documenti cambiati dall'ultima esecuzione - Indicizzatori sostituibili — Passa le modifiche a FlexSearch, Lunr o a un indice tuo
- Viste virtuali — Categorizzate in stile foglio di calcolo, con ordinamento e aggregazione, estese a più database o tenant
Isolamento dei tenant e collaborazione tra tenant
I tenant sono isolati crittograficamente per impostazione predefinita: ognuno ha chiavi di crittografia indipendenti, una directory utenti separata e i propri database. La collaborazione tra tenant è possibile condividendo singoli database o chiavi di crittografia con nome, mentre l'amministrazione resta separata per ogni tenant.
- Ogni tenant ha chiavi di crittografia indipendenti, senza segreti condivisi
- Directory utenti separate, con chiavi di admin indipendenti
- Dati isolati per impostazione predefinita; condividere richiede una distribuzione esplicita delle chiavi
- Revocare un utente in un tenant non ha effetto sugli altri tenant
- Condividi singoli database tra tenant usando chiavi con nome
- Le viste virtuali possono aggregare dati oltre i confini dei tenant
- Ogni tenant mantiene amministrazione e revoca indipendenti
- Utile per filiere, organizzazioni partner e progetti condivisi
Cosa sapere prima di adottarlo
Ogni architettura porta con sé dei compromessi. La cifratura end-to-end e il design append-only di MindooDB danno garanzie solide di sicurezza e tracciabilità, ma comportano vincoli da conoscere dall'inizio.
Revocare un utente blocca ogni sincronizzazione futura e rifiuta le sue modifiche successive. I dati già sincronizzati sul suo dispositivo locale restano però accessibili: nessun sistema può garantire la cancellazione su un dispositivo che non si riconnette più. Mitigazione: usa chiavi con nome per i documenti sensibili (raggio d'azione più piccolo) e ruota le chiavi quando qualcuno lascia il team. Haven Enterprise aggiunge alle stesse policy di governance una cancellazione remota del dispositivo firmata dall'admin: il tenant viene rimosso da un dispositivo rubato o dismesso alla connessione successiva.
Poiché i dati vengono cifrati prima di lasciare il client, il server non può eseguire query. Si interroga solo lato client, con indicizzazione incrementale, viste virtuali o indicizzatori di ricerca sostituibili. È un compromesso deliberato: riservatezza prima della comodità lato server.
Più chiavi per utente (firma, crittografia, chiavi simmetriche con nome) vanno distribuite in modo sicuro. Mitigazione: una sola password sblocca tutte le chiavi tramite una KDF con salt diversi. Il KeyBag offre un archivio unificato delle chiavi. Il flusso di richiesta e risposta di adesione gestisce lo scambio di chiavi per i nuovi utenti. Haven Enterprise automatizza il lavoro ricorrente: le policy di distribuzione delle chiavi firmate dall'admin forniscono le chiavi a utenti e gruppi — e le ritirano di nuovo — incapsulate per ciascun destinatario, e ogni client riconcilia il proprio KeyBag alla sincronizzazione successiva.
I dati si accumulano perché l'audit trail viene conservato. Mitigazione: lo sharding a livello di database limita la crescita per unità di sincronizzazione. Gli snapshot CRDT riducono il costo della riesecuzione. Quando una normativa impone la cancellazione, c'è il purge GDPR (purgeDocHistory).
MindooDB Haven realizza queste primitive in una PWA per browser: chiavi in mano al client, app in sandbox basate su capability, modalità di sincronizzazione flessibili e una vera piattaforma applicativa. È il modo più rapido per provare MindooDB dall'inizio alla fine.