Gebouwd voor zero trust, ontworpen om te combineren
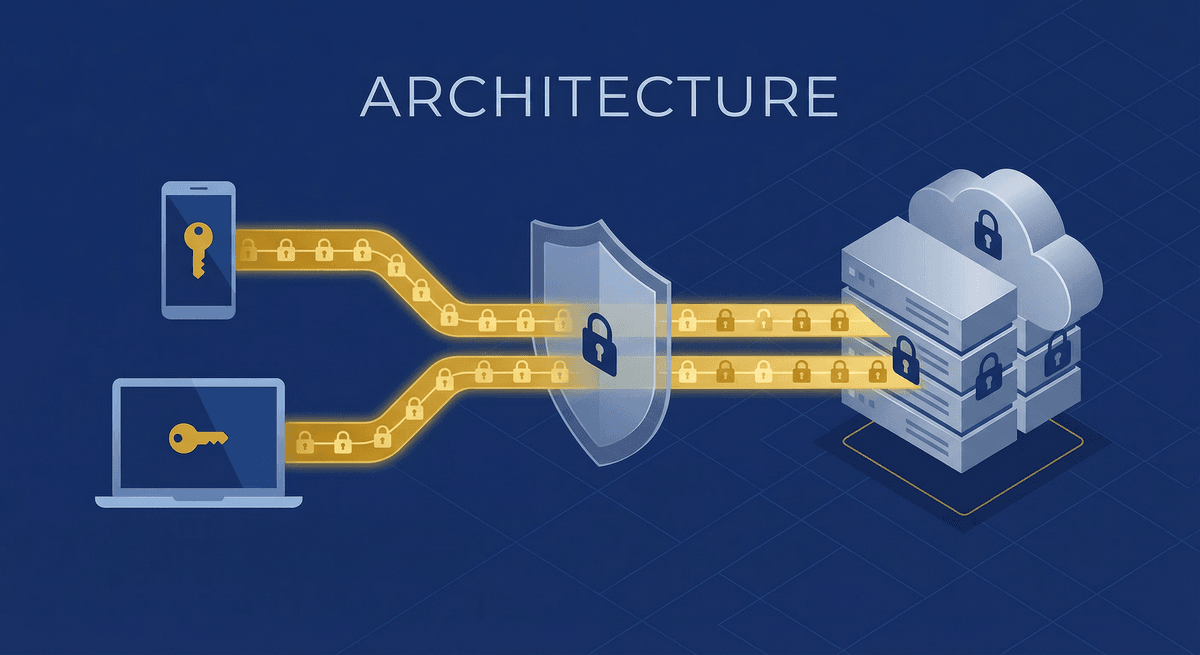
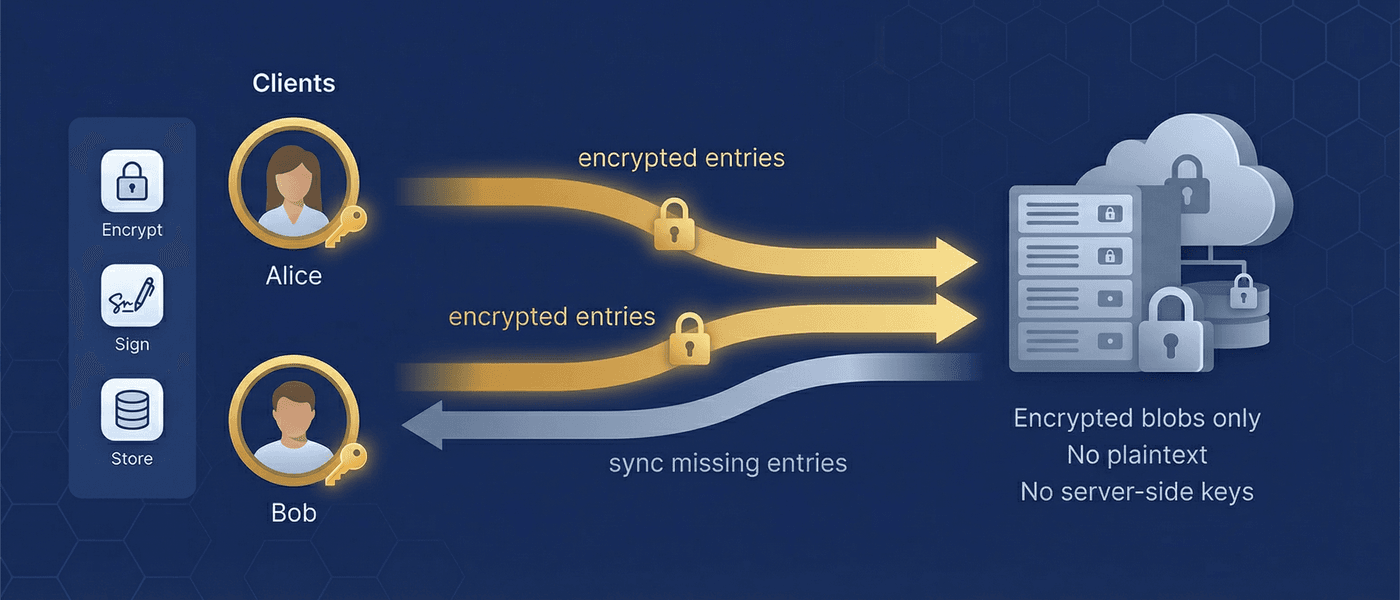
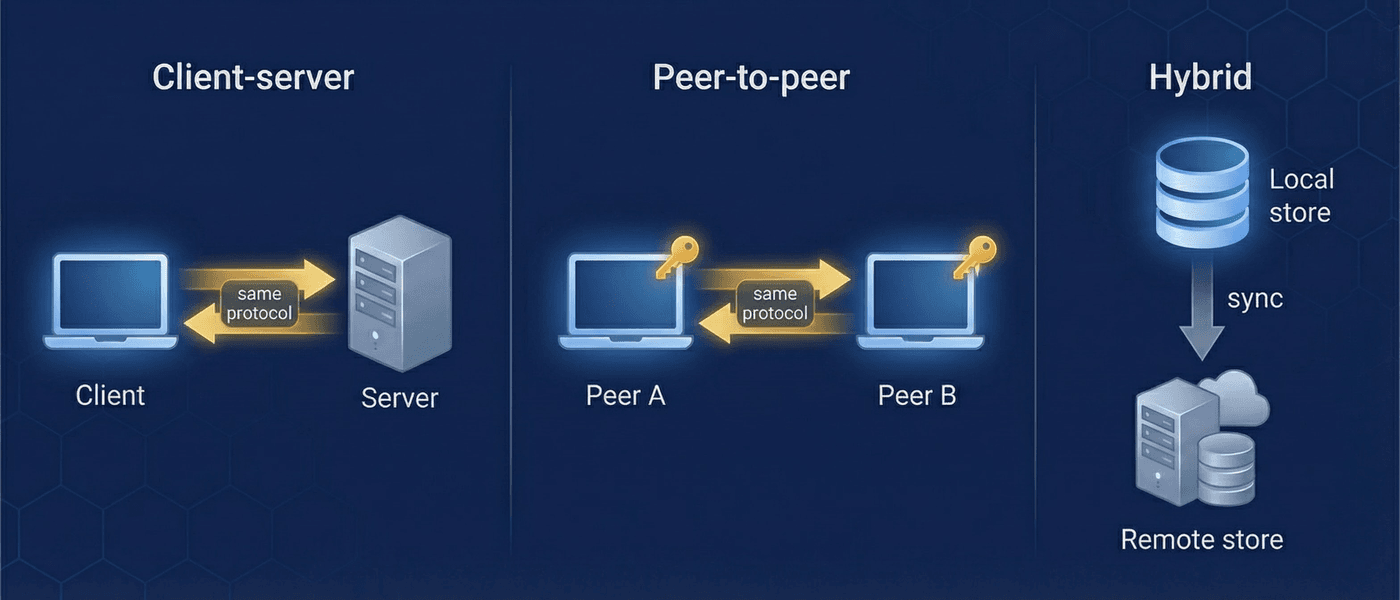
De architectuur van MindooDB scheidt de sync-taak (versleutelde bytes verplaatsen) van de applicatietaak (gegevens ontsleutelen en interpreteren). Die ene ontwerpkeuze maakt client-server-, peer-to-peer-, relay- en mesh-topologieën mogelijk — allemaal met hetzelfde protocol en dezelfde code.
Wat deze architectuur je oplevert
Evalueer je MindooDB voor je team, dan is dit de architectuurvraag die telt: kan ik dit stap voor stap invoeren zonder lock-in? Het antwoord is ja. MindooDB is opgezet voor geleidelijke invoering — begin puur lokaal, voeg client-server-sync toe wanneer het past en zet P2P- of relay-topologieën later aan. Elke stap gebruikt dezelfde ContentAddressedStore-interface, dus een ander deploymentmodel is een kwestie van configuratie en niet van code herschrijven.
Uren voor puur lokaal gebruik. Dagen voor client-server-sync (2 auth- + 3 sync-endpoints). Stap voor stap voor P2P, relay of Bloom-filter-optimalisaties — zonder protocolwijzigingen.
Drie onafhankelijke beschermingslagen: AES-256-GCM in rust, RSA per gebruiker tijdens het transport, TLS op de verbinding. Servers zien nooit leesbare gegevens. Een volledig gekraakte server levert alleen versleutelde gegevens en publieke sleutels op.
Geen gebruikersaccounts op de server, geen opgeslagen wachtwoorden, geen sessiedatabases. De server is een relay voor versleutelde blobs. Gebruikersbeheer gebeurt op de client via cryptografische sleutelparen.
Tenants, gebruikers en de vertrouwensketen
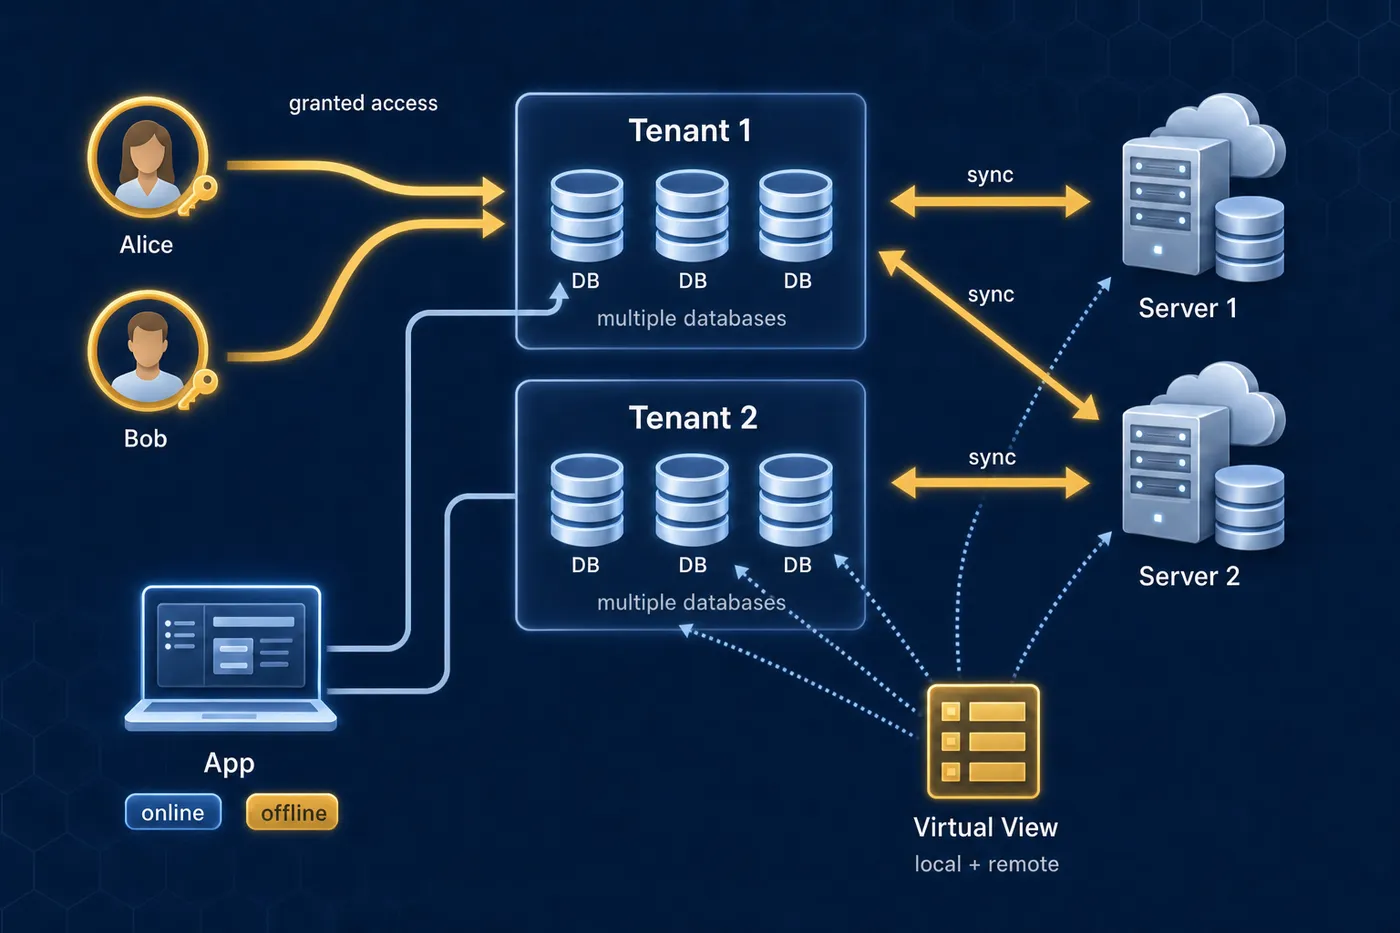
Een MindooDB-tenant staat voor een organisatie of een team. Tenants worden volledig op de client aangemaakt — registratie op een server is niet nodig. Wie een tenant aanmaakt, wordt de beheerder; diens Ed25519-ondertekeningssleutel is de vertrouwensbasis. Elke gebruikersregistratie in de directory wordt met die admin-sleutel ondertekend, en clients en servers controleren die handtekeningen voordat ze de publieke sleutel van een gebruiker vertrouwen. Vertrouwen ontstaat dus uit cryptografisch bewijs, niet uit authenticatie op de server.
Elke tenant bevat een directory-database (het gebruikersregister, alleen voor beheerders), meerdere applicatiedatabases en de sleutels die de toegang bepalen.
- Directory-database — Admin-ondertekende gebruikersregistraties, groepslidmaatschappen, instellingen
- Applicatiedatabases — Worden op verzoek aangemaakt (
tenant.openDB("contacts")) - Documenten — Automerge-CRDT's met ondertekende, versleutelde append-only-geschiedenis
- Bijlagen — Bestandsopslag in chunks (256 KB), versleuteld en gededupliceerd
Vertrouwen loopt van de admin-sleutel via de directory naar de geregistreerde gebruikers. Elk sleuteltype heeft een vast doel:
- Admin-ondertekeningssleutel (Ed25519) — Vertrouwensbasis; ondertekent directory-vermeldingen
- Admin-versleutelingssleutel (RSA-OAEP) — Versleutelt gebruikersnamen ter bescherming van de privacy
- Gebruikers-ondertekeningssleutels (Ed25519) — Bewijzen wie een documentwijziging heeft gemaakt
- Gebruikers-versleutelingssleutels (RSA-OAEP) — Beschermen de lokale KeyBag-opslag
- Standaard-tenant-sleutel (AES-256) — Versleutelt documenten voor alle leden
- Benoemde sleutels (AES-256) — Fijnmazige toegang voor specifieke gebruikers
De content-addressed store
In het hart van de flexibiliteit van MindooDB zit de ContentAddressedStore-interface. Elke store — op de lokale schijf, in het geheugen of achter een netwerkverbinding — implementeert precies dezelfde interface. De sync-methoden pullChangesFrom() en pushChangesTo() accepteren elke ContentAddressedStore en werken daarom identiek, of de andere kant nu een lokale store, een externe server via HTTP of Iroh, of een andere client via Iroh is.
Precies dat ontwerpinzicht maakt elke topologie mogelijk: doordat netwerkstores dezelfde interface implementeren als lokale stores, wordt sync combineerbaar. De onderliggende store van een server kan zelf een externe store zijn (store chaining). Een relay kan versleutelde vermeldingen doorgeven zonder ze te ontsleutelen. Een peer kan dezelfde sync-logica uitvoeren als een server. De topologie is een deploymentkeuze, geen codewijziging.
Elke documentwijziging, elke snapshot en elke bijlage-chunk wordt opgeslagen als een onveranderlijke vermelding met een unieke ID en een content-hash. Vermeldingen worden nooit gewijzigd of verwijderd — dat garandeert een volledig audittrail.
Elke vermelding verwijst via ID naar haar ouder-vermeldingen (samen een DAG) en is ondertekend door wie haar maakte. Wie aan een vermelding morrelt, breekt de ketting — de integriteit is op elk punt controleerbaar.
Vermeldingen worden geïdentificeerd via id en gededupliceerd via contentHash (SHA-256 van de versleutelde payload). Identieke inhoud uit meerdere bronnen wordt één keer opgeslagen.
Eenvoudig beginnen, later optimaliseren
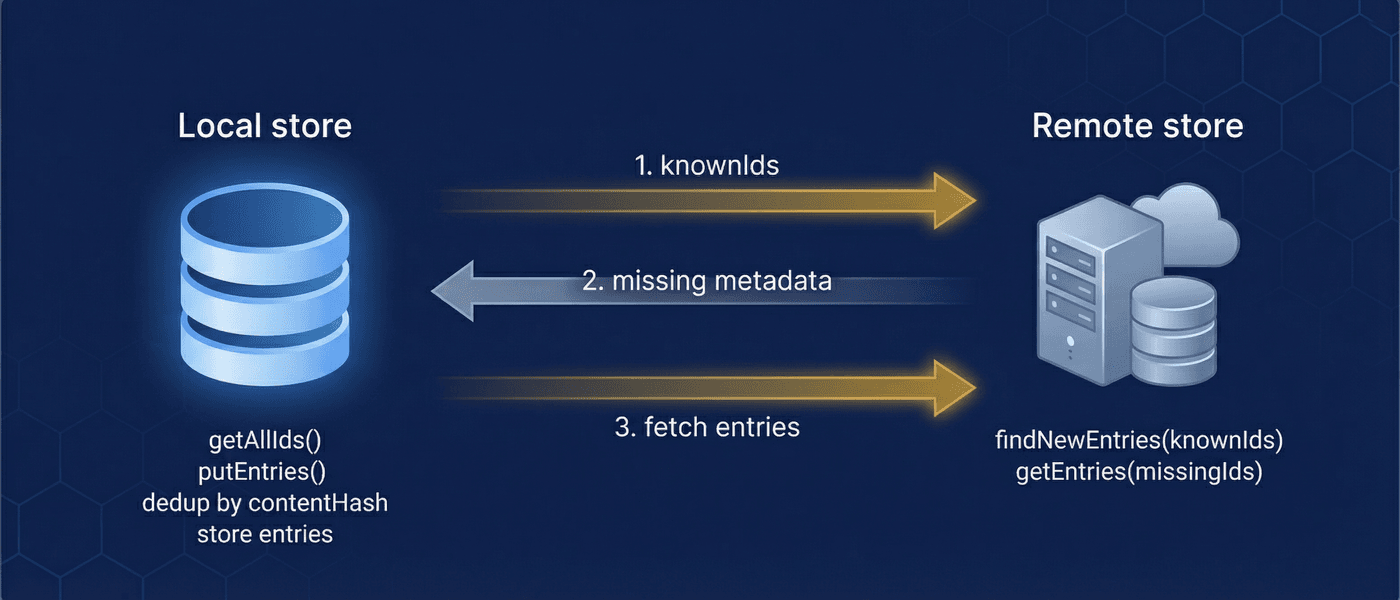
Het sync-protocol biedt drie routes die dezelfde endpoints en hetzelfde vermeldingsmodel delen. Baseline-sync is de eenvoudigste: stuur de ID's die je kent, ontvang metadata van wat je mist en haal die vermeldingen op. Dat werkt bij elke hoeveelheid gegevens en is het aanbevolen startpunt. Geoptimaliseerde sync voegt cursorgebaseerd scannen en Bloom-filter-samenvattingen toe voor grotere hoeveelheden — beide worden tijdens de uitvoering onderhandeld via capability discovery en zijn dus transparant voor de applicatiecode. Dense sync gebruikt de causale materialisatieplanner en zet alleen de vermeldingen over die nodig zijn voor de actuele documentstatus — de beste snapshot plus de wijzigingen die daar niet in zitten. Historische vermeldingen blijven achterwege en bijlagen volgen later. Ideaal voor de eerste inrichting op mobiel bij beperkte bandbreedte.
Deze invarianten gelden in alle deployment-topologieën — client-server, P2P, relayketens en mesh:
- Volledigheid — Na een volledige sync-cyclus kent de client de metadata van elke externe vermelding
- Idempotentie — Elk endpoint kan zonder neveneffecten herhaald worden aangeroepen
- Onafhankelijk van de volgorde — Vermeldingen mogen in willekeurige volgorde aankomen; CRDT's zorgen voor convergentie
- Deduplicatie — Identieke vermeldingen uit meerdere bronnen worden één keer opgeslagen
Vanaf enkele tienduizenden vermeldingen houden twee technieken de sync snel:
- Cursor-scannen — Externe metadata stap voor stap doorlopen in plaats van lange ID-lijsten te versturen. De omvang van een verzoek blijft gelijk, hoe groot de store ook wordt.
- Bloom-filter-samenvatting — Een compacte probabilistische weergave van de verzameling downloaden en ID's daarmee voorfilteren. Bespaart 90-99% van de exacte controles.
- CRDT-snapshots — Regelmatige snapshots voorkomen dat het opnieuw afspelen van lange documentgeschiedenissen de prestaties drukt.
- Dense sync — Per document alleen de nieuwste snapshot en de nog niet gedekte wijzigingen overzetten, zonder geschiedenis en bijlagen. Meer hierover →
Elke sync-bewerking vereist authenticatie via challenge-response: de client ondertekent een challenge van de server met zijn Ed25519-sleutel en de server geeft een kortlevende JWT uit. Het intrekken werkt op twee punten — bij het aanmaken van de challenge en bij het controleren van het token — dus een ingetrokken gebruiker is meteen buitengesloten, ook midden in een sessie. Op de server staan geen wachtwoorden of tokens. Dezelfde challenge en dezelfde JWT gelden als de server via Iroh bereikt wordt: het ticket vervangt het adres, niet de controle. Een verbinding van apparaat naar apparaat heeft geen JWT — het ontvangende apparaat autoriseert de beller zelf.
Hetzelfde protocol, elke netwerkvorm
Omdat sync met versleutelde vermeldingen werkt en overal dezelfde ContentAddressedStore-interface gebruikt, kan elke knoop meedoen zonder gegevens te ontsleutelen. Een relayserver bewaart en geeft vermeldingen door die hij niet kan lezen. Een regionale cache levert vermeldingen aan clients in de buurt zonder sleutels te hebben. De vertrouwensgrens ligt op het niveau van de versleutelingssleutels, niet op dat van de netwerktopologie.
Standaardopstelling met één centrale server. Het eenvoudigst om op te zetten en te beheren. De server controleert gebruikers via de directory, bewaart versleutelde vermeldingen en synchroniseert met de verbonden clients. HTTP is de standaard. Een server zonder publieke URL kan in plaats daarvan op Iroh luisteren en bereikt worden met een iroh:-ticket — zonder DynDNS, port forwarding of certificaat.
Twee apparaten van dezelfde tenant synchroniseren direct via Iroh (QUIC), zonder MindooDB-server ertussen. Native clients proberen eerst een direct pad en vallen anders terug op een relay; een browsertab gaat altijd via een relay. Het ontvangende apparaat controleert zelf handtekeningen en toegangsregels, omdat een peer geen getuigenisbewijs afgeeft. Dezelfde pullChangesFrom/pushChangesTo-API als bij client-server.
Gegevens lopen door knopen die ze niet kunnen ontsleutelen. Een ziekenhuisserver synchroniseert patiëntdossiers tussen klinieken zonder ze te lezen. Een passthrough-knoop stuurt verzoeken door naar een origin-server, bijvoorbeeld voor edge-caching of duidelijke toegangsgrenzen.
| Topologie | Wanneer gebruiken | Benodigde infrastructuur | Belangrijkste voordeel |
|---|---|---|---|
| Client-server | Standaard startpunt; betrouwbare sync die altijd aan staat | Eén server + clients (HTTP of Iroh) | Eenvoudigste deployment |
| Peer-to-peer | Sync van apparaat naar apparaat, zonder MindooDB-server ertussen | Clients + Iroh (relay als NAT blokkeert) | Geen server in het pad |
| Relay | Verspreiding via niet-vertrouwde knopen | Relayserver (zonder sleutels) | Veilige gegevensverspreiding |
| Store chain | Edge-caching, geografische spreiding | Origin + edge-knopen | Minder latentie |
| Mesh | Robuuste convergentie over veel peers | Meerdere peers | Geen single point of failure |
| Hybride | Server voor betrouwbaarheid, peers terwijl de server uit ligt | Server + directe peerverbindingen | Het beste van twee werelden |
Crashveiligheid en gegevensintegriteit
MindooDB legt versleutelde, content-addressed vermeldingen rechtstreeks op het bestandssysteem vast. Daardoor houdt de store zelf de volledige regie over commit-volgorde, herstel na een crash en deduplicatie, zonder een ingebouwde database-engine als SQLite of LevelDB.
Elke schrijfactie volgt een atomair protocol: naar een tijdelijk bestand schrijven, fsync, atomair hernoemen, de bovenliggende map fsyncen. Wie leest, ziet nooit een half geschreven toestand. De commit-volgorde (eerst de payload, dan de metadata, dan het indexsegment) zorgt dat een vermelding pas vindbaar wordt als haar payload veilig op schijf staat.
- Crash tussen payload en metadata — De verweesde payload is onschadelijk
- Crash tussen metadata en index — De vermelding is vastgelegd; de index wordt bij het starten opnieuw opgebouwd
- Crash tijdens compactie — Een verouderde index wordt herkend en opnieuw opgebouwd uit de gezaghebbende vermeldingsbestanden
Bij het starten probeert de store eerst het snelle herstel: de metadata-snapshot laden, incrementele segmenten opnieuw afspelen en valideren tegen de gezaghebbende vermeldingsbestanden. Is iets verouderd of inconsistent, dan valt hij terug op een volledige herbouw vanaf schijf — ongemerkt en zonder gegevensverlies.
- Indexen in het geheugen — O(1)-opzoekacties, cursor-scans met binair zoeken, query's per document
- Segmentcompactie — Voegt incrementele metadata samen in verse snapshots en houdt het starten snel
- Bron van waarheid — De vermeldingsbestanden op schijf zijn altijd gezaghebbend; indexbestanden versnellen alleen en kunnen veilig worden verwijderd
De volledige uitleg over de implementatie staat in de documentatie over de on-disk store.
Gegevens indelen met groei in het achterhoofd
De append-only-architectuur van MindooDB betekent dat gegevens in de loop van de tijd groeien. Omdat elke wijziging bewaard blijft voor het audittrail, is het slim om die groei in te plannen. Het belangrijkste middel is sharding op databaseniveau: gegevens opsplitsen over aparte databases per periode, categorie, toegangsniveau of regio. Elke database synchroniseert zelfstandig, dus je bepaalt precies welke gegevens waarheen gaan.
- Per periode — Databases per jaar of maand houden de sync van actieve gegevens snel en bewaren de geschiedenis
- Per categorie — Aparte databases per documenttype, project of bedrijfsonderdeel
- Per toegangsniveau — Gegevens scheiden op beschermingsniveau, zodat teams verschillende delen synchroniseren
- Per regio — Eén database per regio voor eisen aan de locatie van gegevens
Documenten zijn versleuteld opgeslagen, dus query's op de server zijn uitgesloten. In plaats daarvan biedt MindooDB incrementele indexering op de client:
- Cursorgebaseerde verwerking —
iterateChangesSince(cursor)verwerkt alleen documenten die sinds de vorige ronde zijn gewijzigd - Verwisselbare indexers — Wijzigingen doorgeven aan FlexSearch, Lunr of een eigen index
- Virtuele weergaven — Spreadsheetachtig en gecategoriseerd, met sortering en aggregatie, over meerdere databases of tenants heen
Tenant-isolatie en samenwerking tussen tenants
Tenants zijn standaard cryptografisch van elkaar gescheiden — elke tenant heeft eigen versleutelingssleutels, een eigen gebruikersdirectory en eigen databases. Samenwerken tussen tenants kan door specifieke databases of benoemde versleutelingssleutels te delen; het beheer blijft daarbij per tenant gescheiden.
- Elke tenant heeft eigen versleutelingssleutels — geen gedeelde geheimen
- Gescheiden gebruikersdirectory's met eigen admin-sleutels
- Gegevens zijn standaard gescheiden; delen vereist een uitdrukkelijke sleuteldistributie
- Een gebruiker in één tenant intrekken heeft geen gevolgen voor andere tenants
- Specifieke databases tussen tenants delen via benoemde sleutels
- Virtuele weergaven kunnen gegevens over tenantgrenzen heen samenbrengen
- Elke tenant houdt eigen beheer en kan zelf toegang intrekken
- Nuttig voor toeleveringsketens, partnerorganisaties en gedeelde projecten
Wat je moet weten voordat je begint
Elke architectuur brengt trade-offs mee. De end-to-end-versleuteling en het append-only-ontwerp van MindooDB geven sterke garanties voor beveiliging en controleerbaarheid, maar ze brengen beperkingen mee die je vooraf moet kennen.
Een gebruiker intrekken blokkeert alle verdere sync en wijst zijn volgende wijzigingen af. Gegevens die al naar zijn apparaat zijn gesynchroniseerd, blijven daar echter leesbaar — geen enkel systeem kan verwijdering garanderen op een apparaat dat nooit meer verbinding maakt. Beperk het risico: gebruik benoemde sleutels voor gevoelige documenten (kleiner bereik) en roteer sleutels als gebruikers vertrekken. Haven Enterprise voegt aan diezelfde governance-beleidsregels een admin-ondertekend wissen op afstand toe: de tenant verdwijnt van een gestolen of afgedankt apparaat zodra dat weer verbinding maakt.
Omdat gegevens al versleuteld zijn voordat ze de client verlaten, kan de server geen query's uitvoeren. Alle query's lopen via de client: incrementele indexering, virtuele weergaven of verwisselbare zoekindexers. Dat is een bewuste trade-off: vertrouwelijkheid boven gemak op de server.
Meerdere sleutels per gebruiker (ondertekening, versleuteling, benoemde symmetrische sleutels) moeten veilig worden verdeeld. Beperk het risico: één wachtwoord ontgrendelt alle sleutels via een KDF met verschillende salts. De KeyBag biedt daarvoor één gezamenlijke sleutelopslag. De join-request/response-flow regelt de sleuteluitwisseling voor nieuwe gebruikers. Haven Enterprise automatiseert het werk daarna: admin-ondertekende beleidsregels voor sleuteldistributie geven sleutels aan gebruikers en groepen — en trekken ze weer in — per ontvanger ingepakt, en elke client stemt zijn KeyBag bij de volgende sync af.
Gegevens groeien omdat het audittrail bewaard blijft. Beperk het risico: sharding op databaseniveau begrenst de groei per sync-eenheid. CRDT-snapshots verlagen de kosten van het opnieuw afspelen. Moet er wettelijk verwijderd worden, dan is er het AVG-wissen (purgeDocHistory).
MindooDB Haven brengt deze bouwstenen samen in een PWA in de browser: sleutels blijven bij de gebruiker, apps lopen in een sandbox met vaste rechten, plus flexibele sync-modi en een echt app-platform. Sneller ervaar je MindooDB van begin tot eind niet.