Consulta todo. No reproceses nada.
El almacén append-only de MindooDB y el seguimiento de cambios con cursor permiten construir índices que se mantienen al día procesando solo lo que ha cambiado — sin volver a recorrer toda la base de datos. El mismo primitivo sostiene las vistas virtuales, la búsqueda de texto completo, la sincronización con sistemas externos y las consultas de viaje en el tiempo.
Por qué importa la indexación incremental
En una base de datos cifrada de extremo a extremo, el servidor no puede ejecutar consultas — todos los datos son texto cifrado. MindooDB lo resuelve con indexación incremental en el cliente: una única API basada en cursor que solo procesa los documentos modificados. Sostiene desde las vistas jerárquicas de informes hasta la búsqueda de texto completo y las auditorías de cumplimiento, sin necesitar nunca un escaneo completo de la base de datos. El resultado es un rendimiento predecible que escala con la tasa de cambio, no con el tamaño de tus datos.
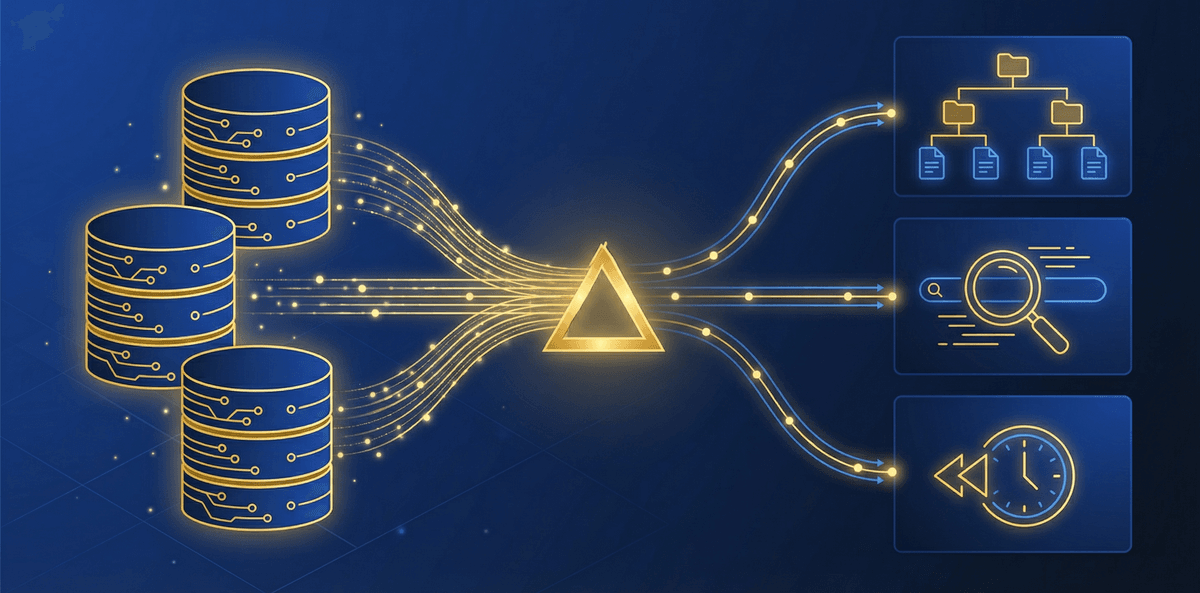
iterateChangesSince() es la base común de las vistas virtuales, la búsqueda de texto completo, la sincronización con sistemas externos y los análisis propios. Aprende una API y desbloquea todos los patrones de consulta.
Las vistas virtuales abarcan varias bases de datos dentro de un tenant, cruzan tenants o mezclan datos locales y remotos — sin mover ningún documento. Ideales para paneles consolidados e informes entre organizaciones.
El almacén append-only conserva cada cambio. Consulta cualquier estado pasado, compara cómo evoluciona un documento en el tiempo, crea snapshots de la base de datos a una fecha concreta y construye registros de auditoría completos — todo a partir de los mismos datos.
iterateChangesSince() — procesar solo lo que ha cambiado
Toda estrategia de consulta en MindooDB parte del mismo primitivo: un generador asíncrono basado en cursor que entrega los documentos en orden de modificación. En la primera llamada recorre toda la base de datos; en las siguientes retoma exactamente donde lo dejó. Los documentos borrados vienen con un marcador de borrado, así los índices posteriores pueden limpiar. El coste de cada pasada es proporcional al número de cambios desde el último cursor — no al tamaño total de la base de datos.
- Basado en cursor — pasa
nullpara el primer recorrido y después el último cursor devuelto para las actualizaciones incrementales - Orden de modificación — los documentos llegan con el cambio más antiguo primero, así los índices ven un avance consistente
- Consciente de los borrados — los documentos borrados aparecen con el indicador
isDeleted()para quitarlos de los índices sin residuos - Lotes al ritmo del consumidor — el generador asíncrono se puede detener en cualquier punto y retomar más tarde
- O(changed) — cada pasada incremental procesa solo los documentos modificados desde el último cursor
- Sin escaneos completos — el índice interno lleva
(lastModified, docId)para que el cursor retome de forma eficiente - Consumidores intercambiables — un solo flujo de cambios puede alimentar varios indexadores en una única pasada
- Funciona sin conexión — los índices se actualizan en local; la sincronización trae los cambios remotos y después los indexadores procesan el delta
Vistas jerárquicas con categorías, ordenación y totales
Las vistas virtuales organizan los documentos en una estructura de árbol en memoria — piensa en un índice dinámico que categoriza, ordena y agrega tus datos. Inspiradas en el probado paradigma de vistas de HCL Notes/Domino, admiten jerarquías de categorías anidadas, ordenación ascendente y descendente por varias columnas y agregaciones SUM y AVERAGE integradas en las filas de categoría. Las actualizaciones son incrementales: cuando un documento cambia, la vista solo actualiza las ramas afectadas.
- Columnas de categoría — agrupan los documentos en jerarquías anidadas (p. ej. Departamento > Año > Trimestre)
- Columnas ordenadas — ordenan las entradas de cada categoría por uno o varios campos
- Columnas de total — SUM o AVERAGE automáticos por categoría, actualizados de forma incremental
- Columnas de visualización — datos adicionales mostrados junto a cada entrada
- Funciones de valor — calculan los valores de columna dinámicamente a partir de los datos del documento
- Expandir y contraer — entra en las categorías o ciérralas, como en un explorador de archivos
- Navegación por posición — salta a "1.2.3" (primera categoría, segunda subcategoría, tercera entrada)
- Selección — selecciona entradas concretas o categorías completas para operaciones por lotes
- Callbacks de control de acceso — filtran las entradas visibles según el usuario sin cambiar la estructura de la vista
- Iteración hacia delante y hacia atrás — recorre el árbol en cualquier dirección
Una vista, muchas bases de datos — incluso entre tenants
Una de las capacidades más potentes de las vistas virtuales es reunir documentos de varias instancias de MindooDB en una sola vista unificada. Cada fuente de datos se identifica con una cadena "origin", así que siempre sabes de qué base de datos (y de qué tenant) viene un documento. Eso hace sencillo construir paneles consolidados, informes entre regiones y análisis entre organizaciones — sin mover ni duplicar datos.
Combina una base de datos de productos de EE. UU. con otra de la UE en un único catálogo de productos. La vista categoriza y ordena a través de las dos fuentes. Cada entrada lleva su origin, así que tu interfaz puede mostrar la región de procedencia.
Extiende las vistas a distintos MindooTenants para informes entre organizaciones. Dos organizaciones comparten datos en un tercer tenant; una vista consolidada agrega los ingresos de los tres — y cada tenant conserva su administración independiente.
Cada proveedor de datos lleva su propio cursor de forma independiente. Llamar a view.update() procesa solo los documentos que han cambiado en cada fuente desde la última pasada. También puedes actualizar un solo origin con view.updateOrigin("us-products").
Envía actualizaciones incrementales a cualquier indexador o pipeline
El mismo primitivo iterateChangesSince() que sostiene las vistas virtuales puede alimentar cualquier sistema externo. Úsalo para mantener al día un índice de texto completo, enviar cambios a una pipeline de analítica o replicar datos en un servicio externo. Como el cursor registra exactamente qué documentos se han procesado, la integración no pierde ningún cambio y no vuelve a procesar datos sin necesidad.
La búsqueda de texto completo en el cliente es el complemento natural del cifrado de extremo a extremo — y MindooDB la trae de serie: un índice de texto completo opcional (basado en MiniSearch) que se mantiene con el changefeed, se guarda cifrado en reposo y se integra directamente en las consultas con resultados ordenados por relevancia.
- Contenido variado — texto plano, campos de texto de Automerge, fragmentos de texto enriquecido y el texto de los adjuntos (PDF/Office)
- Integración con las consultas — combina las coincidencias de texto completo con filtros estructurados y ordenación por relevancia
- Consciente del idioma — tokenización con
Intl.Segmenter, configurable en cada base de datos - Indexadores externos — FlexSearch, Lunr.js o sistemas propios siguen siendo intercambiables a través del changefeed
Construye pipelines de datos que reaccionan a los cambios en los documentos. El patrón de generador asíncrono te deja procesar los cambios a tu ritmo, con control de contrapresión incluido.
- Alimentar la analítica — envía métricas agregadas a los paneles
- Disparadores de webhook — avisan a sistemas externos cuando cambian determinados documentos
- Pipelines ETL — extraen y transforman datos para los sistemas de informes
- Replicación — copia los datos a sistemas secundarios con semántica exactly-once
Un gestor de índices puede coordinar varios indexadores desde un solo flujo de cambios. Procesa cada documento modificado una vez y reparte las actualizaciones a todos los índices registrados — vistas virtuales, búsqueda de texto completo, analítica y consumidores propios — en una única pasada. Cada indexador lleva su propio estado, así que añadir o reconstruir uno no afecta a los demás.
Consulta el pasado, compara cambios, construye registros de auditoría
El almacén append-only de MindooDB conserva cada cambio de cada documento. Eso habilita tres capacidades potentes: recuperar un documento en cualquier marca de tiempo del pasado, recorrer el historial completo de cambios de un documento y listar todos los documentos que existían en un momento concreto. Juntas sostienen las auditorías de cumplimiento, la comparación de versiones, el deshacer y rehacer y los snapshots de la base de datos a una fecha concreta.
getDocumentAtTimestamp()— recupera una instantánea de un documento en cualquier marca de tiempo pasada, aplicando todos los cambios hasta ese momentogetAllDocumentIdsAtTimestamp()— obtiene de forma eficiente todos los IDs de documento que existían en un momento dado, sin cargar el contenido- Tratamiento de los documentos borrados — distingue entre "aún no existía" (devuelve
null) y "se borró" (devuelve el documento con el indicadorisDeleted())
iterateDocumentHistory()— recorre cada cambio desde la creación hasta el estado actual, en orden cronológico- Metadatos de autoría — cada cambio incluye la marca de tiempo y la clave pública de firma del usuario que lo hizo
- Clones independientes — cada versión de documento entregada es una instantánea independiente, segura para guardar y comparar
- Detección de cambios — solo entrega algo cuando el documento cambió de verdad (se salta las actualizaciones sin efecto)
Crea instancias de base de datos aparte, sincronizadas a cualquier fecha
Como el protocolo de sincronización de MindooDB transfiere entradas de cambio individuales con su marca de tiempo, puedes crear una instancia de base de datos nueva y sincronizarla solo hasta un momento concreto. Eso te da una instantánea congelada de la base de datos en ese instante — útil para auditorías reglamentarias, análisis reproducibles o comparar el estado de tus datos entre periodos. El almacén append-only garantiza que la instantánea sea completa y a prueba de manipulaciones.
Crea una copia congelada de tu base de datos al cierre de cada trimestre fiscal. Los auditores pueden verificar por su cuenta el estado de los documentos, las firmas de autoría y el historial de cambios — todo demostrable criptográficamente.
Compara conjuntos de documentos en dos marcas de tiempo para ver qué se creó, se modificó o se borró en el intervalo. Combínalo con getDocumentAtTimestamp() para ver exactamente cómo evolucionó cada documento.
Ejecuta la misma vista virtual o consulta contra snapshots de la base de datos en fechas distintas. Compara resultados mes a mes o trimestre a trimestre sin mantener bases de datos de informes aparte.
Patrones para copiar y pegar
Estos fragmentos proceden de la documentación y de la batería de pruebas de MindooDB, para que reflejen patrones de uso reales.
Cómo encaja la indexación incremental en la arquitectura de MindooDB
En MindooDB el contenido de los documentos está cifrado de extremo a extremo. El servidor solo guarda texto cifrado y no puede ejecutar consultas. Es un trade-off de seguridad consciente: la confidencialidad por delante de la comodidad en el servidor. La indexación en el cliente devuelve las capacidades de consulta que esperas — con la garantía de que tus datos nunca quedan expuestos al servidor.
El enfoque incremental lo mantiene practicable a gran escala. En lugar de reconstruir los índices desde cero tras cada sincronización, el cursor retoma exactamente donde lo dejó y procesa solo el delta. En una base de datos con 100.000 documentos de los que 50 han cambiado desde la última sincronización, el indexador procesa 50 documentos — no 100.000.
El almacén append-only de MindooDB es lo que hace posibles todos estos patrones. Como los cambios nunca se sobrescriben:
- Los cursores son estables — el orden de modificación no cambia, así que retomar desde un cursor siempre es consistente
- El viaje en el tiempo sale gratis — el historial completo ya está guardado; no hacen falta registros ni snapshots adicionales
- Los registros de auditoría vienen incluidos — cada cambio va firmado y con marca de tiempo por su autor
- Las actualizaciones incrementales son correctas — el flujo de cambios es completo y ordenado; no se pierde ninguna
Esto contrasta con las bases de datos mutables, en las que implementar el seguimiento de cambios, el historial y la indexación incremental exige infraestructura adicional (WAL, CDC, change streams, tablas de auditoría).