Zbudowana pod zero trust, zaprojektowana pod składalność
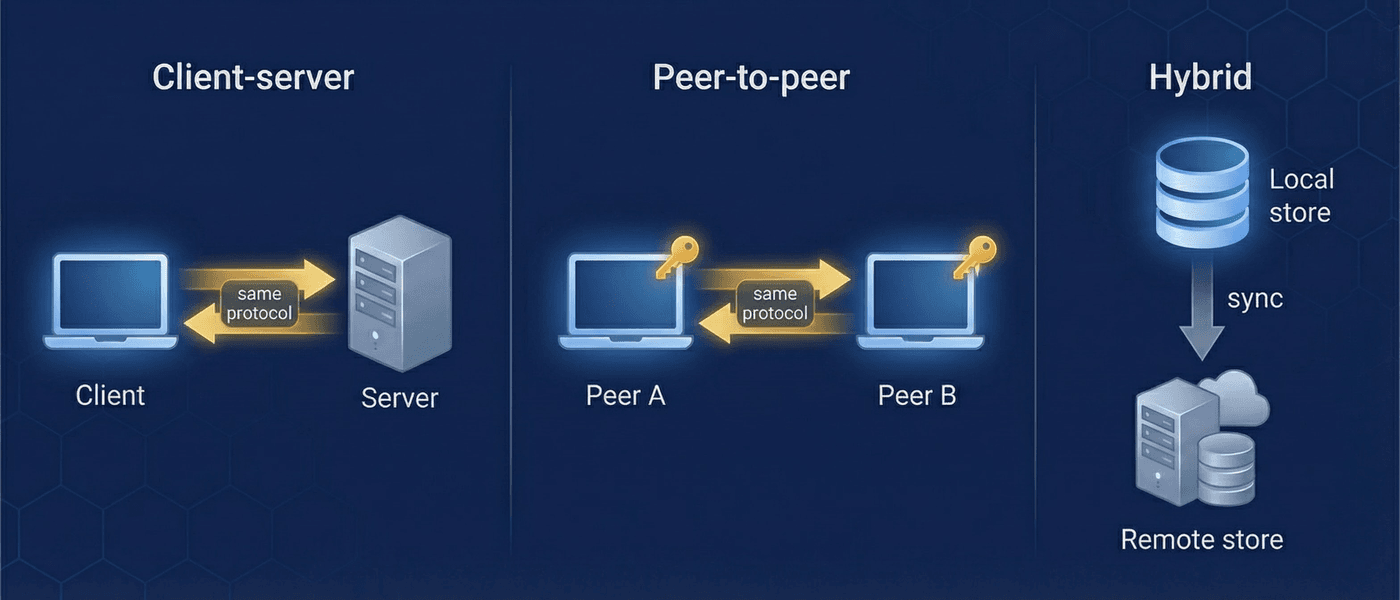
Architektura MindooDB rozdziela zadanie synchronizacji (przenoszenie zaszyfrowanych bajtów) od zadania aplikacji (odszyfrowanie i interpretacja danych). Ta jedna decyzja projektowa otwiera topologie klient-serwer, peer-to-peer, relay i mesh — wszystkie na tym samym protokole i tym samym kodzie.
Co daje ta architektura
Jeśli oceniasz MindooDB dla swojego zespołu, kluczowe pytanie architektoniczne brzmi: czy da się to wdrażać etapami, bez uzależnienia od dostawcy? Da się. MindooDB jest zaprojektowany pod stopniowe wdrożenie — zacznij wyłącznie lokalnie, dodaj synchronizację klient-serwer, gdy przyjdzie czas, a topologie P2P lub relay włącz później. Każdy krok korzysta z tego samego interfejsu ContentAddressedStore, więc zmiana modelu wdrożenia to decyzja konfiguracyjna, a nie przepisywanie kodu.
Godziny przy pracy wyłącznie lokalnej. Dni przy synchronizacji klient-serwer (2 endpointy uwierzytelniania + 3 synchronizacji). Etapami dla P2P, relay i optymalizacji filtrem Bloom — bez żadnych zmian w protokole.
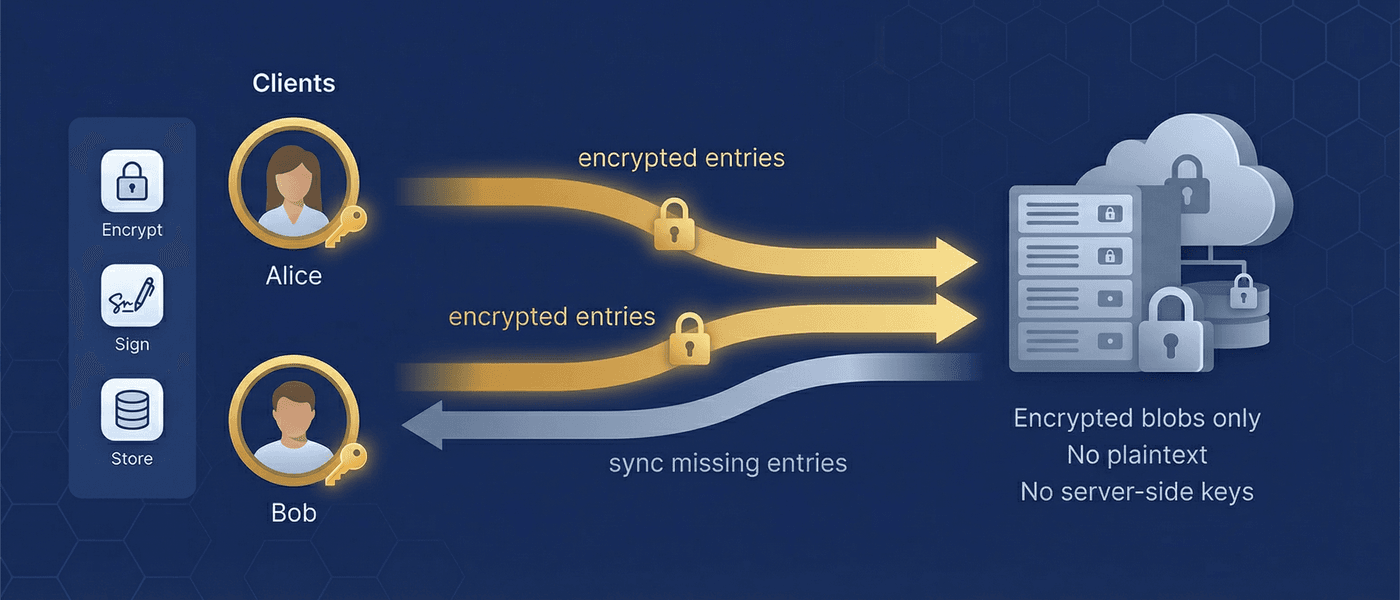
Trzy niezależne warstwy ochrony: AES-256-GCM w spoczynku, RSA na użytkownika w tranzycie, TLS na łączu. Serwery nigdy nie widzą tekstu jawnego. Pełne włamanie na serwer daje tylko szyfrogram i klucze publiczne.
Żadnych kont użytkowników po stronie serwera, żadnego przechowywania haseł, żadnych baz sesji. Serwer jest przekaźnikiem zaszyfrowanych blobów. Zarządzanie użytkownikami dzieje się na kliencie, przez pary kluczy kryptograficznych.
Tenanty, użytkownicy i łańcuch zaufania
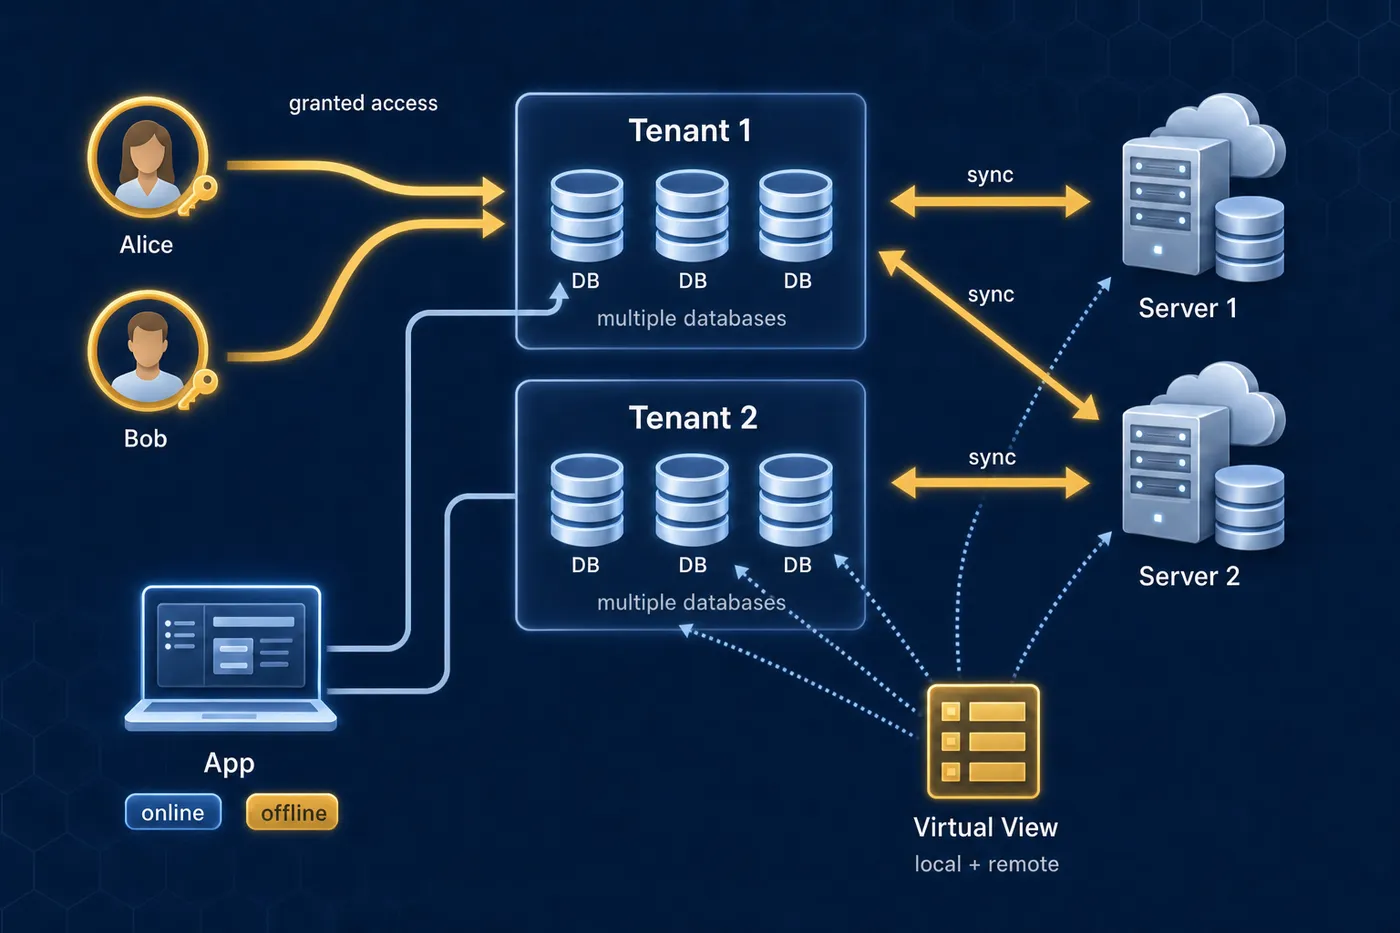
Tenant w MindooDB odpowiada organizacji lub zespołowi. Tenanty powstają w całości na kliencie — rejestracja na serwerze nie jest potrzebna. Kto zakłada tenanta, zostaje jego administratorem, a jego klucz podpisujący Ed25519 jest korzeniem zaufania. Każda rejestracja użytkownika w katalogu jest podpisana tym kluczem administratora, a klient i serwer sprawdzają te podpisy, zanim zaufają czyjemuś kluczowi publicznemu. Zaufanie opiera się więc na dowodach kryptograficznych, nie na uwierzytelnianiu przez serwer.
Każdy tenant zawiera bazę danych katalogu (rejestr użytkowników, tylko dla administratora), wiele baz danych aplikacji oraz klucze, które sterują dostępem.
- Baza danych katalogu — Podpisane przez administratora rejestracje użytkowników, członkostwa w grupach, ustawienia
- Bazy danych aplikacji — Zakładane na żądanie (
tenant.openDB("contacts")) - Dokumenty — CRDT Automerge z podpisaną, zaszyfrowaną historią append-only
- Załączniki — Magazyn plików dzielonych na fragmenty po 256 KB, zaszyfrowany i deduplikowany
Zaufanie płynie od klucza administratora przez katalog do zarejestrowanych użytkowników. Każdy typ klucza ma swoje jedno zadanie:
- Klucz podpisujący administratora (Ed25519) — Korzeń zaufania; podpisuje wpisy katalogu
- Klucz szyfrujący administratora (RSA-OAEP) — Szyfruje nazwy użytkowników dla ochrony prywatności
- Klucze podpisujące użytkowników (Ed25519) — Dowodzą autorstwa zmian w dokumentach
- Klucze szyfrujące użytkowników (RSA-OAEP) — Chronią lokalny magazyn KeyBag
- Domyślny klucz tenanta (AES-256) — Szyfruje dokumenty dla wszystkich członków
- Nazwane klucze (AES-256) — Precyzyjny dostęp dla wybranych użytkowników
Magazyn adresowany treścią
W centrum elastyczności MindooDB stoi interfejs ContentAddressedStore. Każdy magazyn — na lokalnym dysku, w pamięci czy za połączeniem sieciowym — implementuje ten sam interfejs. Metody synchronizacji pullChangesFrom() i pushChangesTo() przyjmują dowolny ContentAddressedStore, więc działają identycznie, niezależnie od tego, czy po drugiej stronie jest magazyn lokalny, zdalny serwer przez HTTP lub Iroh, czy inny klient połączony przez Iroh.
To właśnie ta myśl projektowa otwiera każdą topologię: skoro magazyny sieciowe implementują ten sam interfejs co magazyny lokalne, synchronizacja staje się składalna. Magazynem bazowym serwera może być kolejny magazyn zdalny (łańcuch magazynów). Relay może przekazywać zaszyfrowane wpisy dalej, nie odszyfrowując ich. Peer może wykonywać tę samą logikę synchronizacji co serwer. Topologia jest decyzją wdrożeniową, nie zmianą w kodzie.
Każda zmiana dokumentu, każda migawka i każdy fragment załącznika jest zapisywany jako niezmienny wpis z unikalnym identyfikatorem i skrótem treści. Wpisy nigdy nie są modyfikowane ani usuwane — to gwarantuje pełną ścieżkę audytu.
Każdy wpis wskazuje po identyfikatorze na swoje wpisy nadrzędne (powstaje z tego DAG) i jest podpisany przez twórcę. Manipulacja którymkolwiek wpisem rozrywa łańcuch — integralność da się sprawdzić w każdym punkcie.
Wpisy są identyfikowane przez id i deduplikowane przez contentHash (SHA-256 zaszyfrowanego payloadu). Identyczna treść z wielu źródeł zapisywana jest raz.
Zacznij prosto, optymalizuj później
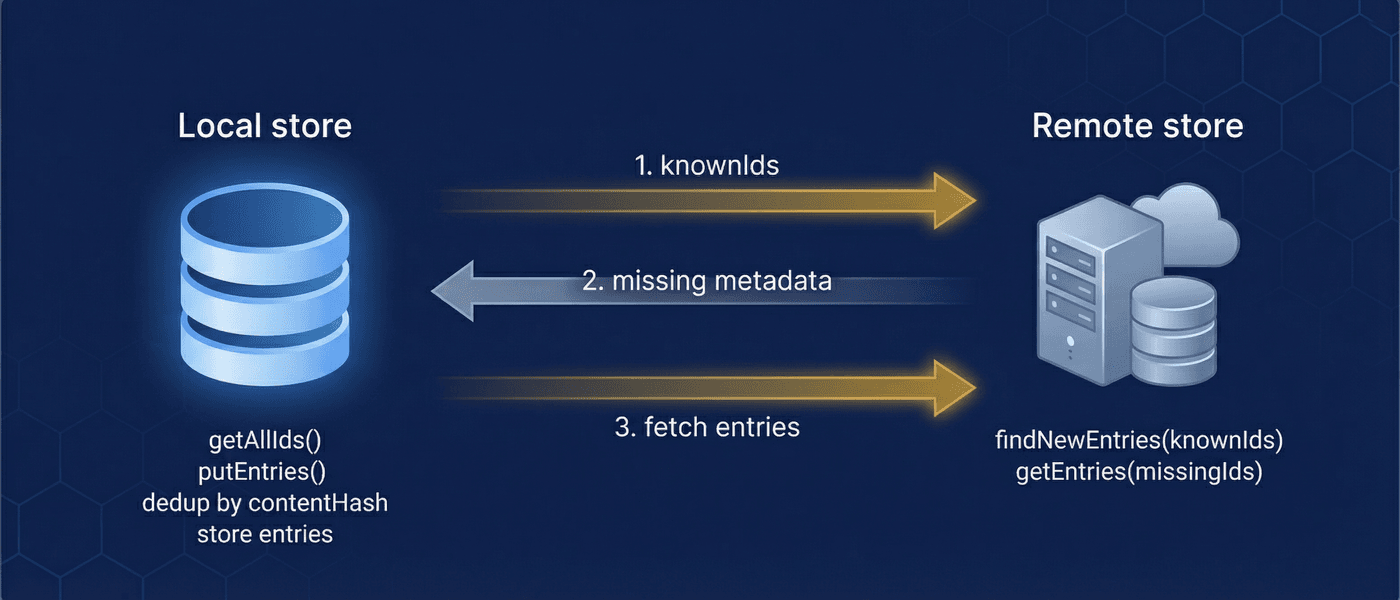
Protokół synchronizacji daje trzy drogi, które dzielą te same endpointy i ten sam model wpisu. Synchronizacja bazowa jest najprostsza: wyślij identyfikatory znanych wpisów, odbierz metadane tego, czego brakuje, pobierz te wpisy. Działa przy każdym rozmiarze zbioru danych i od niej warto zacząć. Synchronizacja zoptymalizowana dodaje skanowanie kursorem i podsumowania filtrem Bloom dla większych zbiorów — jedno i drugie jest negocjowane w czasie działania przez capability discovery, więc dla kodu aplikacji pozostaje przezroczyste. Synchronizacja gęsta korzysta z planera materializacji przyczynowej i przesyła tylko te wpisy, które są potrzebne do najnowszego stanu dokumentu — najlepszą migawkę plus nieobjęte nią zmiany — pomijając wpisy historyczne i odkładając załączniki. Idealna do pierwszej konfiguracji na urządzeniu mobilnym przy ograniczonym pasmie.
Te niezmienniki obowiązują we wszystkich topologiach wdrożenia — klient-serwer, P2P, łańcuchach relay i mesh:
- Kompletność — Po pełnym cyklu synchronizacji klient zna metadane każdego zdalnego wpisu
- Idempotencja — Każdy endpoint można wywoływać wielokrotnie bez efektów ubocznych
- Niezależność od kolejności — Wpisy mogą docierać w dowolnej kolejności; zbieżność zapewniają CRDT
- Deduplikacja — Identyczne wpisy z wielu źródeł zapisywane raz
Powyżej kilkudziesięciu tysięcy wpisów te techniki utrzymują szybką synchronizację:
- Skanowanie kursorem — Przechodzenie zdalnych metadanych stronami, zamiast wysyłania długich list identyfikatorów. Rozmiar żądania pozostaje stały, niezależnie od wielkości magazynu.
- Podsumowanie filtrem Bloom — Pobranie zwięzłej, probabilistycznej reprezentacji zbioru do wstępnego filtrowania identyfikatorów. Eliminuje 90-99% dokładnych sprawdzeń istnienia.
- Migawki CRDT — Regularne migawki chronią przed spadkiem wydajności przy odtwarzaniu długiej historii dokumentu.
- Synchronizacja gęsta — Przesyła dla każdego dokumentu tylko najnowszą migawkę i nieobjęte nią zmiany, bez historii i załączników. Dowiedz się więcej →
Każda operacja synchronizacji wymaga uwierzytelnienia w schemacie challenge-response: klient podpisuje wygenerowane przez serwer wyzwanie swoim kluczem Ed25519, a serwer wystawia krótkotrwały token JWT. Odwołanie działa w dwóch miejscach — przy generowaniu wyzwania i przy sprawdzaniu tokenu — więc odwołany użytkownik traci dostęp natychmiast, także w środku sesji. Na serwerze nie są przechowywane ani hasła, ani tokeny. To samo wyzwanie i ten sam JWT obowiązują, gdy serwer jest osiągany przez Iroh: ticket zastępuje adres, nie kontrolę. Połączenie z urządzenia na urządzenie nie ma JWT — urządzenie odbierające samo autoryzuje wywołującego.
Ten sam protokół, dowolny kształt sieci
Ponieważ synchronizacja operuje na zaszyfrowanych wpisach i wszędzie korzysta z tego samego interfejsu ContentAddressedStore, każdy węzeł może w niej uczestniczyć, nie odszyfrowując danych. Serwer relay przechowuje i przekazuje dalej wpisy, których nie potrafi przeczytać. Regionalna pamięć podręczna wydaje wpisy pobliskim klientom bez żadnych kluczy. Granica zaufania leży na poziomie kluczy szyfrujących, nie na poziomie topologii sieci.
Standardowe wdrożenie z centralnym serwerem. Najprostsze w postawieniu i utrzymaniu. Serwer weryfikuje użytkowników przez katalog, przechowuje zaszyfrowane wpisy i synchronizuje się z podłączonymi klientami. HTTP jest domyślny. Serwer bez publicznego adresu URL może zamiast tego nasłuchiwać na Iroh i dać się osiągnąć ticketem iroh: — bez DynDNS, przekierowania portu i certyfikatu.
Dwa urządzenia tego samego tenanta synchronizują się wprost przez Iroh (QUIC), bez serwera MindooDB po drodze. Klienci natywni próbują najpierw ścieżki bezpośredniej, a gdy to się nie uda, schodzą na relay; karta przeglądarki idzie zawsze przez relay. Urządzenie odbierające samo sprawdza podpisy i reguły dostępu, bo peer nie wystawia pokwitowania świadka. To samo API pullChangesFrom/pushChangesTo co przy klient-serwer.
Dane płyną przez węzły, które nie potrafią ich odszyfrować. Serwer szpitala synchronizuje dokumentację pacjentów między przychodniami, nie czytając jej. Węzeł przekazujący kieruje żądania do serwera źródłowego — na przykład dla pamięci podręcznej na brzegu sieci albo dla wyraźnych granic dostępu.
| Topologia | Kiedy stosować | Potrzebna infrastruktura | Główna zaleta |
|---|---|---|---|
| Klient-serwer | Domyślny start; niezawodna stała synchronizacja | Jeden serwer + klienty (HTTP lub Iroh) | Najprostsze wdrożenie |
| Peer-to-peer | Synchronizacja z urządzenia na urządzenie, bez serwera MindooDB po drodze | Klienty + Iroh (relay, gdy NAT blokuje) | Brak serwera na ścieżce |
| Relay | Rozsyłanie danych przez niezaufane węzły | Serwer relay (bez kluczy) | Bezpieczna dystrybucja danych |
| Łańcuch magazynów | Cache na brzegu, rozproszenie geograficzne | Źródło + węzły brzegowe | Mniejsze opóźnienia |
| Mesh | Odporna zbieżność wielu peerów | Wiele peerów | Brak pojedynczego punktu awarii |
| Hybryda | Serwer dla niezawodności, peery gdy jest wyłączony | Serwer + bezpośrednie łącza peer | Zalety obu podejść |
Bezpieczeństwo przy awarii i integralność danych
MindooDB zapisuje zaszyfrowane, adresowane treścią wpisy wprost w systemie plików. Dzięki temu magazyn ma pełną kontrolę nad kolejnością zatwierdzeń, odzyskiwaniem po awarii i deduplikacją, bez zależności od wbudowanego silnika bazy danych w rodzaju SQLite czy LevelDB.
Każdy zapis pliku przebiega atomowo: zapis do pliku tymczasowego, fsync, atomowa zmiana nazwy, fsync katalogu nadrzędnego. Czytający nigdy nie widzą stanu zapisanego w połowie. Kolejność zatwierdzania (najpierw payload, potem metadane, na końcu segment indeksu) sprawia, że wpis staje się odnajdywalny dopiero wtedy, gdy jego payload jest bezpiecznie na dysku.
- Awaria między payloadem a metadanymi — Osierocony payload jest nieszkodliwy
- Awaria między metadanymi a indeksem — Wpis jest zatwierdzony; indeks odbudowany przy starcie
- Awaria w trakcie kompaktowania — Przestarzały indeks zostaje rozpoznany i odbudowany z rozstrzygających plików wpisów
Przy starcie magazyn próbuje najpierw szybkiej ścieżki: wczytuje migawkę metadanych, odtwarza segmenty przyrostowe i sprawdza je wobec rozstrzygających plików wpisów. Jeśli cokolwiek jest przestarzałe lub niespójne, przechodzi na pełną odbudowę z dysku — przezroczyście i bez utraty danych.
- Indeksy w pamięci — Wyszukiwanie punktowe O(1), skanowanie kursorem przez wyszukiwanie binarne, zapytania w zakresie dokumentu
- Kompaktowanie segmentów — Scala przyrostowe metadane w świeże migawki i utrzymuje szybki start
- Źródło prawdy — Pliki wpisów na dysku są zawsze rozstrzygające; pliki indeksu to struktury przyspieszające, które można bezpiecznie usunąć
Pełne szczegóły implementacji znajdziesz w dokumentacji magazynu na dysku.
Organizacja danych pod wzrost
Architektura append-only w MindooDB oznacza, że dane rosną z czasem. Skoro każda zmiana zostaje zachowana na potrzeby ścieżki audytu, warto ten wzrost zaplanować. Podstawowym narzędziem jest sharding na poziomie bazy danych: podział danych na osobne bazy według okresu, kategorii, poziomu dostępu lub regionu. Każda baza synchronizuje się niezależnie, więc dokładnie kontrolujesz, które dane gdzie płyną.
- Według czasu — Bazy roczne lub miesięczne trzymają szybką synchronizację danych bieżących i zachowują historię
- Według kategorii — Osobne bazy według typu dokumentu, projektu lub działu
- Według dostępu — Rozdzielenie danych po poziomie ochrony, żeby zespoły synchronizowały różne podzbiory
- Według regionu — Baza na region dla wymogów miejsca przechowywania danych
Dokumenty są zaszyfrowane w spoczynku, więc zapytania po stronie serwera są wykluczone. MindooDB daje zamiast tego przyrostowe indeksowanie na kliencie:
- Przetwarzanie kursorem —
iterateChangesSince(cursor)przetwarza tylko dokumenty zmienione od ostatniego przebiegu - Wymienne indeksery — Przekazywanie zmian do FlexSearch, Lunr lub własnego indeksu
- Widoki wirtualne — Skategoryzowane zestawienia w stylu arkusza, z sortowaniem i agregacją, obejmujące wiele baz danych lub tenantów
Izolacja tenantów i współpraca między nimi
Tenanty są domyślnie odizolowane kryptograficznie — każdy ma własne klucze szyfrujące, osobny katalog użytkowników i własny zestaw baz danych. Współpraca między tenantami jest możliwa przez udostępnienie wybranych baz danych albo nazwanych kluczy szyfrujących, przy zachowaniu osobnej administracji każdego tenanta.
- Każdy tenant ma własne klucze szyfrujące — żadnych wspólnych sekretów
- Osobne katalogi użytkowników z własnymi kluczami administratora
- Dane są domyślnie odizolowane; udostępnianie wymaga jawnej dystrybucji kluczy
- Odwołanie użytkownika w jednym tenancie nie wpływa na inne tenanty
- Udostępnianie wybranych baz danych między tenantami nazwanymi kluczami
- Widoki wirtualne mogą łączyć dane ponad granicami tenantów
- Każdy tenant zachowuje własną administrację i własne odwoływanie dostępu
- Przydatne w łańcuchach dostaw, organizacjach partnerskich i wspólnych projektach
Co warto wiedzieć przed wdrożeniem
Każda architektura to kompromisy. Szyfrowanie end-to-end i projekt append-only w MindooDB dają mocne gwarancje bezpieczeństwa i rozliczalności, ale niosą ograniczenia, które warto znać od początku.
Odwołanie użytkownika blokuje każdą dalszą synchronizację i odrzuca jego przyszłe zmiany. Dane już zsynchronizowane na jego urządzeniu pozostają jednak dostępne — żaden system nie zagwarantuje usunięcia na urządzeniu, które nigdy się nie połączy. Środek zaradczy: używaj nazwanych kluczy do wrażliwych dokumentów (mniejszy promień rażenia) i rotuj klucze, gdy ktoś odchodzi z zespołu. Haven Enterprise dodaje do tych samych polityk nadzoru podpisane przez administratora zdalne czyszczenie urządzenia: tenant zostaje usunięty ze skradzionego lub porzuconego urządzenia przy jego następnym połączeniu.
Dane są szyfrowane, zanim opuszczą klienta, więc serwer nie może wykonywać zapytań. Całe odpytywanie dzieje się na kliencie: przez przyrostowe indeksowanie, widoki wirtualne albo wymienne indeksery wyszukiwania. To świadomy kompromis — poufność przed wygodą po stronie serwera.
Wiele kluczy na użytkownika (podpisujący, szyfrujący, nazwane klucze symetryczne) trzeba bezpiecznie rozdystrybuować. Środek zaradczy: jedno hasło odblokowuje wszystkie klucze przez KDF z różnymi solami. KeyBag daje dla nich jednolity magazyn kluczy. Wymianę kluczy dla nowych użytkowników obsługuje przebieg żądania i odpowiedzi dołączenia. Haven Enterprise automatyzuje bieżącą pracę: podpisane przez administratora polityki dystrybucji kluczy przydzielają klucze użytkownikom i grupom — i odbierają je z powrotem — zapakowane osobno dla każdego odbiorcy, a każdy klient uzgadnia swój KeyBag przy następnej synchronizacji.
Dane narastają, bo zachowywana jest ścieżka audytu. Środek zaradczy: sharding na poziomie bazy danych ogranicza wzrost w jednostce synchronizacji. Migawki CRDT obniżają koszt odtwarzania. Gdy usunięcie wymuszają przepisy, dostępne jest czyszczenie na potrzeby RODO (purgeDocHistory).
MindooDB Haven realizuje te elementy w przeglądarkowej aplikacji PWA: klucze zostają u użytkownika, aplikacje działają w piaskownicy z precyzyjnymi uprawnieniami, do tego elastyczne tryby synchronizacji i prawdziwa platforma aplikacji. Szybciej MindooDB od początku do końca nie poznasz.