Tout interroger. Ne rien retraiter.
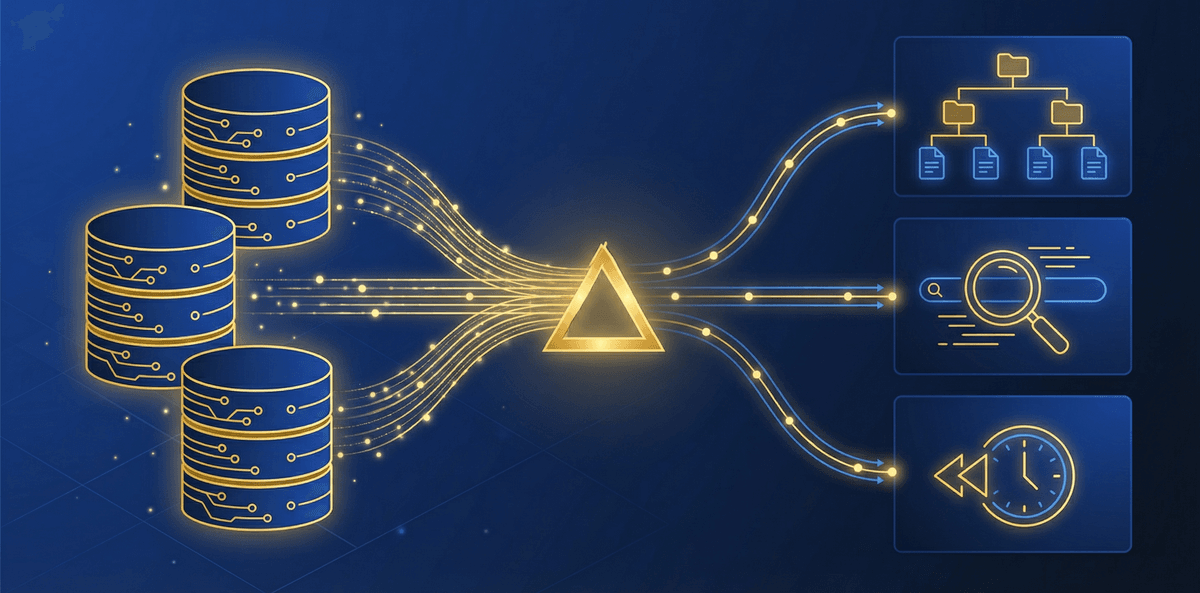
Le store append-only de MindooDB et son suivi des modifications par curseur permettent de construire des index qui restent à jour en ne traitant que ce qui a changé — sans jamais reparcourir toute la base. Le même primitif porte les vues virtuelles, la recherche plein texte, la synchronisation avec des systèmes externes et les requêtes de voyage dans le temps.
Pourquoi l'indexation incrémentale compte
Dans une base chiffrée de bout en bout, le serveur ne peut exécuter aucune requête — toutes les données sont du texte chiffré. MindooDB répond par une indexation incrémentale côté client : une seule API par curseur, qui ne traite que les documents modifiés. Elle porte tout, des vues d'analyse hiérarchiques à la recherche plein texte jusqu'aux audits de conformité, sans jamais exiger un parcours complet de la base. Résultat : des performances prévisibles, qui suivent le rythme des modifications et non le volume des données.
iterateChangesSince() est la base commune des vues virtuelles, de la recherche plein texte, de la synchronisation avec des systèmes externes et de vos propres analyses. Une seule API à apprendre, tous les modèles de requête à la clé.
Les vues virtuelles s'étendent sur plusieurs bases d'un même tenant, par-delà les tenants, ou mêlent données locales et distantes — sans déplacer un seul document. Idéal pour les tableaux de bord consolidés et les analyses entre organisations.
Le store append-only conserve chaque modification. Interrogez n'importe quel état passé, comparez l'évolution des documents dans le temps, créez des snapshots de la base à une date donnée et bâtissez des pistes d'audit complètes — tout à partir des mêmes données.
iterateChangesSince() — ne traiter que ce qui a changé
Toute stratégie de requête dans MindooDB part du même primitif : un générateur asynchrone à curseur qui livre les documents dans l'ordre de leur modification. Au premier appel, il parcourt toute la base ; aux appels suivants, il reprend exactement là où il s'était arrêté. Les documents supprimés sont livrés avec un marqueur de suppression, pour que les index en aval puissent faire le ménage. Le coût de chaque passage est proportionnel au nombre de modifications depuis le dernier curseur — pas à la taille totale de la base.
- Par curseur — passer
nullpour le parcours initial, puis le dernier curseur retourné pour les mises à jour incrémentales - Ordre de modification — les documents arrivent en commençant par la modification la plus ancienne, si bien que les index voient une progression cohérente
- Suppressions comprises — les documents supprimés apparaissent avec le drapeau
isDeleted(), pour un retrait propre des index - Lots pilotés par le consommateur — le générateur asynchrone se laisse arrêter à tout moment et reprendre plus tard
- O(changed) — chaque passage incrémental ne traite que les documents modifiés depuis le dernier curseur
- Aucun parcours complet — l'index interne suit
(lastModified, docId)pour une reprise efficace du curseur - Consommateurs interchangeables — un seul flux de modifications peut alimenter plusieurs indexeurs en un seul passage
- Fonctionne hors ligne — les index se mettent à jour en local ; la synchronisation apporte les modifications distantes, puis les indexeurs traitent le delta
Des vues hiérarchiques avec catégories, tri et totaux
Les vues virtuelles organisent les documents dans une structure d'arbre en mémoire — pensez à une table des matières dynamique qui catégorise, trie et agrège vos données. Inspirées du paradigme de vues éprouvé de HCL Notes/Domino, elles acceptent des hiérarchies de catégories imbriquées, un tri croissant et décroissant sur plusieurs colonnes, ainsi que des agrégations SUM et AVERAGE intégrées sur les lignes de catégorie. Les mises à jour sont incrémentales : quand un document change, la vue ne met à jour que les branches concernées.
- Colonnes de catégorie — regroupent les documents en hiérarchies imbriquées (p. ex. Service > Année > Trimestre)
- Colonnes de tri — trient les entrées de chaque catégorie sur un ou plusieurs champs
- Colonnes de total — SUM ou AVERAGE automatique par catégorie, mis à jour de façon incrémentale
- Colonnes d'affichage — données supplémentaires montrées à côté de chaque entrée
- Fonctions de valeur — calculent dynamiquement les valeurs de colonne à partir des données du document
- Déplier/replier — entrer dans les catégories ou les refermer, comme dans un explorateur de fichiers
- Navigation par position — sauter directement à « 1.2.3 » (première catégorie, deuxième sous-catégorie, troisième entrée)
- Sélection — choisir des entrées isolées ou des catégories entières pour des opérations en lot
- Callbacks de contrôle d'accès — filtrer les entrées visibles par utilisateur sans toucher à la structure de la vue
- Itération avant et arrière — parcourir l'arbre dans les deux sens
Une seule vue, plusieurs bases de données — même entre tenants
L'une des plus grandes forces des vues virtuelles est de pouvoir réunir dans une seule vue unifiée des documents venus de plusieurs instances MindooDB. Chaque source de données est identifiée par une chaîne « origin », si bien qu'on sait toujours de quelle base (et de quel tenant) vient un document. Bâtir des tableaux de bord consolidés, des rapports interrégionaux et des analyses entre organisations devient donc simple — sans déplacer ni dupliquer les données.
Réunissez une base de produits américaine et une base de produits européenne en un seul catalogue. La vue catégorise et trie à travers les deux sources. Chaque entrée porte son origin, si bien que votre interface peut afficher la région d'origine.
Étendez des vues à plusieurs MindooTenants pour des analyses entre organisations. Deux organisations partagent des données dans un troisième tenant ; une vue consolidée agrège le chiffre d'affaires des trois — chaque tenant garde son administration indépendante.
Chaque fournisseur de données suit son propre curseur de façon indépendante. Un appel à view.update() ne traite que les documents modifiés dans chaque source depuis le dernier passage. On peut aussi mettre à jour un seul origin avec view.updateOrigin("us-products").
Pousser des mises à jour incrémentales vers n'importe quel indexeur ou pipeline
Le primitif iterateChangesSince() qui porte les vues virtuelles peut alimenter n'importe quel système externe. Servez-vous en pour garder un index plein texte à jour, pousser des modifications dans une pipeline d'analyse ou répliquer des données vers un service externe. Comme le curseur retient exactement quels documents ont été traités, votre intégration ne manque jamais une modification et ne retraite jamais des données pour rien.
La recherche plein texte côté client est le complément naturel du chiffrement de bout en bout — et MindooDB la fournit d'origine : un index plein texte optionnel, entretenu par le changefeed (sur la base de MiniSearch), conservé chiffré au repos et intégré directement aux requêtes, avec des résultats classés par pertinence.
- Contenus variés — texte simple, champs de texte Automerge, fragments de texte enrichi, texte des pièces jointes (PDF/Office)
- Intégration aux requêtes — combiner les correspondances plein texte avec des filtres structurés et un tri par pertinence
- Conscient de la langue — segmentation par
Intl.Segmenter, configurable par base de données - Indexeurs externes — FlexSearch, Lunr.js ou vos propres systèmes restent branchables via le changefeed
Construisez des pipelines de données qui réagissent aux modifications de documents. Grâce au modèle du générateur asynchrone, vous traitez les modifications à votre rythme, avec la régulation de charge incluse.
- Flux d'analyse — pousser des indicateurs agrégés vers des tableaux de bord
- Déclencheurs webhook — prévenir des systèmes externes quand certains documents changent
- Pipelines ETL — extraire et transformer des données pour des systèmes d'analyse
- Réplication — refléter les données vers des systèmes secondaires, avec une sémantique exactly-once
Un gestionnaire d'index peut coordonner plusieurs indexeurs depuis un seul flux de modifications. Chaque document modifié est traité une fois, et les mises à jour partent vers tous les index enregistrés — vues virtuelles, recherche plein texte, analyses et consommateurs sur mesure — en un seul passage. Chaque indexeur suit son propre état : ajouter ou reconstruire un indexeur n'a aucun effet sur les autres.
Interroger le passé, comparer les modifications, bâtir des pistes d'audit
Le store append-only de MindooDB conserve chaque modification de document. Trois possibilités fortes en découlent : retrouver un document à n'importe quel horodatage passé, parcourir tout l'historique des modifications d'un document et lister tous les documents qui existaient à un instant donné. Ensemble, elles portent les audits de conformité, la comparaison de versions, l'annulation/rétablissement et les snapshots de la base à une date donnée.
getDocumentAtTimestamp()— retrouve l'état d'un document à n'importe quel horodatage passé, en appliquant toutes les modifications jusqu'à cet instantgetAllDocumentIdsAtTimestamp()— récupère efficacement tous les identifiants de documents qui existaient à un instant donné, sans charger le contenu- Traitement des documents supprimés — distingue « n'existait pas encore » (renvoie
null) de « a été supprimé » (renvoie le document avec le drapeauisDeleted())
iterateDocumentHistory()— parcourt chaque modification, de la création à l'état actuel, dans l'ordre chronologique- Métadonnées d'auteur — chaque modification porte son horodatage et la clé de signature publique de l'utilisateur qui l'a faite
- Copies indépendantes — chaque version de document livrée est un état autonome, que l'on peut stocker et comparer sans risque
- Détection des modifications — ne livre que si le document a réellement changé (les mises à jour sans effet sont ignorées)
Créer des instances de base distinctes, synchronisées à n'importe quelle date
Comme le protocole de synchronisation de MindooDB transfère des entrées de modification individuelles horodatées, vous pouvez créer une nouvelle instance de base et ne la synchroniser que jusqu'à un instant précis. Vous obtenez un état figé de la base à ce moment-là — utile pour les audits réglementaires, les analyses reproductibles ou la comparaison de vos données d'une période à l'autre. Le store append-only garantit que ce snapshot est complet et infalsifiable.
Créez une copie figée de votre base à la fin de chaque trimestre fiscal. Les auditeurs peuvent vérifier de façon indépendante l'état des documents, les signatures d'auteur et l'historique des modifications — tout est prouvable cryptographiquement.
Comparez des ensembles de documents à deux horodatages pour voir ce qui a été créé, modifié ou supprimé entre les deux. Avec getDocumentAtTimestamp(), on suit précisément l'évolution de chaque document.
Exécutez la même vue virtuelle ou la même requête sur des snapshots de la base à différentes dates. Comparez les résultats d'un mois ou d'un trimestre à l'autre sans entretenir de bases d'analyse séparées.
Des modèles à copier-coller
Ces extraits proviennent de la documentation et de la suite de tests de MindooDB, pour rester fidèles aux usages réels.
Comment l'indexation incrémentale s'inscrit dans l'architecture MindooDB
Dans MindooDB, le contenu des documents est chiffré de bout en bout. Le serveur ne stocke que du texte chiffré et ne peut exécuter aucune requête. C'est un compromis de sécurité délibéré : la confidentialité plutôt que le confort côté serveur. L'indexation côté client rétablit les possibilités de requête attendues — avec la garantie que vos données ne sont jamais exposées au serveur.
L'approche incrémentale garde cela praticable à grande échelle. Au lieu de reconstruire les index de zéro après chaque synchronisation, le curseur reprend exactement là où il s'était arrêté et ne traite que le delta. Sur une base de 100 000 documents dont 50 ont changé depuis la dernière synchronisation, l'indexeur traite 50 documents — pas 100 000.
C'est le store append-only de MindooDB qui rend tous ces modèles possibles. Comme les modifications ne sont jamais écrasées :
- Les curseurs sont stables — l'ordre des modifications ne bouge pas, reprendre depuis un curseur est donc toujours cohérent
- Le voyage dans le temps ne coûte rien — l'historique complet est déjà stocké ; aucun journal ni snapshot supplémentaire n'est nécessaire
- Les pistes d'audit sont intégrées — chaque modification est signée et horodatée par son auteur
- Les mises à jour incrémentales sont exactes — le flux de modifications est complet et ordonné ; aucune mise à jour ne se perd
C'est tout le contraire des bases modifiables, où le suivi des modifications, l'historique et l'indexation incrémentale demandent une infrastructure supplémentaire (WAL, CDC, change streams, tables d'audit).