Spør om alt. Behandle ingenting på nytt.
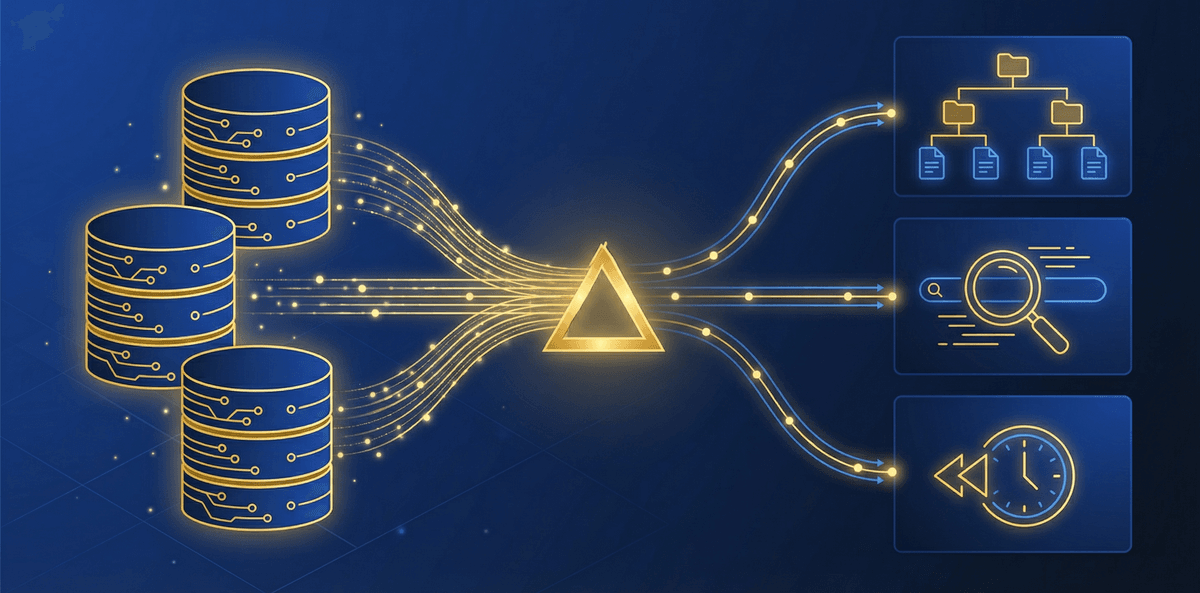
Append-only-lageret i MindooDB og den cursorbaserte endringssporingen lar deg bygge indekser som holder seg oppdatert ved bare å behandle det som er endret — uten å skanne hele databasen på nytt. Det samme primitivet bærer virtuelle visninger, fulltekstsøk, synkronisering med eksterne systemer og tidsreisespørringer.
Derfor betyr inkrementell indeksering noe
I ende-til-ende-krypterte databaser kan ikke serveren kjøre spørringer — alle data er chiffertekst. MindooDB løser det med inkrementell indeksering på klientsiden: ett cursorbasert API som bare behandler endrede dokumenter. Det bærer alt fra hierarkiske rapportvisninger via fulltekstsøk til revisjoner for etterlevelse, uten at en full skanning av databasen noen gang trengs. Resultatet er forutsigbar ytelse som skalerer med endringstakten, ikke med datamengden.
iterateChangesSince() er det ene fundamentet for virtuelle visninger, fulltekstsøk, synkronisering med eksterne systemer og egne analyser. Lær ett API, og du har alle spørringsmønstrene.
Virtuelle visninger spenner over flere databaser i én tenant, på tvers av tenants, eller blander lokale og eksterne data — uten å flytte dokumenter. Ideelt til samlede dashbord og rapportering på tvers av organisasjoner.
Append-only-lageret bevarer hver endring. Spør mot enhver tidligere tilstand, sammenlign hvordan dokumenter har utviklet seg, lag øyeblikksbilder av databasen for et gitt tidspunkt, og bygg komplette revisjonsspor — alt fra de samme dataene.
iterateChangesSince() — behandle bare det som er endret
Hver spørringsstrategi i MindooDB starter med det samme primitivet: en cursorbasert asynkron generator som leverer dokumenter i den rekkefølgen de ble endret. Ved første kall går den gjennom hele databasen; ved neste kall fortsetter den nøyaktig der den slapp. Slettede dokumenter følger med som slettemarkering, så indekser nedstrøms kan rydde opp. Kostnaden ved hver kjøring er proporsjonal med antallet endringer siden forrige cursor — ikke med den totale størrelsen på databasen.
- Cursorbasert — send
nullfor første gjennomgang, deretter den sist returnerte cursoren for inkrementelle oppdateringer - Endringsrekkefølge — dokumenter kommer med den eldste endringen først, så indekser ser et konsistent forløp
- Slettinger inkludert — slettede dokumenter dukker opp med
isDeleted()-flagg og kan fjernes rent fra indekser - Batching styrt av konsumenten — den asynkrone generatoren kan stoppes når som helst og fortsettes senere
- O(changed) — hver inkrementelle kjøring behandler bare dokumenter som er endret siden forrige cursor
- Ingen fulle skanninger — den interne indeksen fører
(lastModified, docId), så cursoren kan fortsette effektivt - Pluggbare konsumenter — én endringsstrøm kan forsyne flere indeksere i én gjennomgang
- Virker offline — indekser oppdateres lokalt; synkroniseringen henter eksterne endringer, og så behandler indekserne deltaet
Hierarkiske visninger med kategorier, sortering og summer
Virtuelle visninger ordner dokumenter i en trestruktur i minnet — tenk på det som en dynamisk innholdsfortegnelse som kategoriserer, sorterer og aggregerer dataene dine. De er inspirert av det velprøvde visningsparadigmet fra HCL Notes/Domino og støtter nestede kategorihierarkier, stigende og synkende sortering på flere kolonner og innebygde SUM- og AVERAGE-aggregeringer på kategorirader. Oppdateringene er inkrementelle: endres et dokument, oppdaterer visningen bare de greinene det berører.
- Kategorikolonner — grupperer dokumenter i nestede hierarkier (f.eks. Avdeling > År > Kvartal)
- Sorteringskolonner — sorterer oppføringene innenfor hver kategori etter ett eller flere felter
- Sumkolonner — automatisk SUM eller AVERAGE per kategori, oppdatert inkrementelt
- Visningskolonner — flere data vist ved siden av hver oppføring
- Verdifunksjoner — beregner kolonneverdier dynamisk ut fra dokumentdataene
- Utvid og skjul — bor deg ned i kategorier eller slå dem sammen, som i en filutforsker
- Posisjonsbasert navigasjon — hopp rett til «1.2.3» (første kategori, andre underkategori, tredje oppføring)
- Utvalg — velg enkeltoppføringer eller hele kategorier for masseoperasjoner
- Callbacks for tilgangskontroll — filtrer synlige oppføringer per bruker uten å endre strukturen i visningen
- Iterasjon forover og bakover — gå gjennom treet i begge retninger
Én visning, mange databaser — også på tvers av tenants
En av de sterkeste egenskapene til virtuelle visninger er at de kan samle dokumenter fra flere MindooDB-instanser i én enhetlig visning. Hver datakilde identifiseres med en «origin»-streng, så du vet alltid hvilken database (og hvilken tenant) et dokument kom fra. Det gjør det rett fram å bygge samlede dashbord, rapporter på tvers av regioner og analyser på tvers av organisasjoner — uten å flytte eller duplisere data.
Slå sammen en amerikansk og en europeisk produktdatabase til én produktkatalog. Visningen kategoriserer og sorterer på tvers av begge kildene. Hver oppføring bærer sin origin, så grensesnittet kan vise hvilken region den kom fra.
Spenn visninger over ulike MindooTenants for rapportering på tvers av organisasjoner. To organisasjoner deler data i en tredje tenant; en samlet visning aggregerer omsetningen over alle tre — hver tenant beholder sin egen administrasjon.
Hver dataleverandør fører sin egen cursor uavhengig. Et kall til view.update() behandler bare dokumentene som er endret i hver kilde siden forrige kjøring. Du kan også oppdatere én enkelt origin med view.updateOrigin("us-products").
Send inkrementelle oppdateringer til enhver indekser eller pipeline
Det samme primitivet iterateChangesSince() som bærer virtuelle visninger, kan forsyne ethvert eksternt system. Bruk det til å holde en fulltekstindeks oppdatert, sende endringer videre til en analysepipeline eller replikere data til en ekstern tjeneste. Fordi cursoren holder nøyaktig styr på hvilke dokumenter som er behandlet, går integrasjonen aldri glipp av en endring og behandler aldri data på nytt uten grunn.
Fulltekstsøk på klientsiden er den naturlige følgesvennen til ende-til-ende-kryptering — og MindooDB har det med rett ut av boksen: en fulltekstindeks du slår på selv, vedlikeholdt over changefeeden (bygget på MiniSearch), som lagres kryptert og går rett inn i spørringene med treff rangert etter relevans.
- Rikt innhold — ren tekst, Automerge-tekstfelter, rike tekstavsnitt, tekst i vedlegg (PDF/Office)
- Integrert i spørringene — kombiner fulltekstreff med strukturerte filtre og sortering etter relevans
- Språkbevisst — tokenisering med
Intl.Segmenter, konfigurerbar per database - Eksterne indeksere — FlexSearch, Lunr.js eller egne systemer kan fortsatt kobles på via changefeeden
Bygg datapipelines som reagerer på dokumentendringer. Mønsteret med asynkrone generatorer gjør at du behandler endringene i ditt eget tempo, med backpressure innebygd.
- Analysestrømmer — send aggregerte nøkkeltall til dashbord
- Webhook-utløsere — varsle eksterne systemer når bestemte dokumenter endrer seg
- ETL-pipelines — hent ut og transformer data for rapporteringssystemer
- Replikering — speil data til sekundærsystemer med exactly-once-semantikk
En indeks-manager kan koordinere flere indeksere fra én enkelt endringsstrøm. Hvert endret dokument behandles én gang, og oppdateringene fordeles til alle registrerte indekser — virtuelle visninger, fulltekstsøk, analyse og egne konsumenter — i én gjennomgang. Hver indekser fører sin egen tilstand, så å legge til eller bygge opp igjen én indekser påvirker ikke de andre.
Spør mot fortiden, sammenlign endringer, bygg revisjonsspor
Append-only-lageret i MindooDB bevarer hver eneste dokumentendring. Det gir tre kraftige muligheter: å hente et dokument på et hvilket som helst historisk tidsstempel, å gå gjennom hele endringshistorikken til et dokument, og å liste opp alle dokumentene som fantes på et bestemt tidspunkt. Sammen bærer de revisjoner for etterlevelse, versjonssammenligning, angre og gjøre om, og øyeblikksbilder av databasen for et gitt tidspunkt.
getDocumentAtTimestamp()— henter et øyeblikksbilde av et dokument på et hvilket som helst tidligere tidsstempel, med alle endringer fram til det øyeblikketgetAllDocumentIdsAtTimestamp()— henter effektivt alle dokument-ID-er som fantes på et bestemt tidspunkt, uten å laste innhold- Håndtering av slettede dokumenter — skiller mellom «fantes ikke ennå» (gir
null) og «ble slettet» (gir dokumentet medisDeleted()-flagg)
iterateDocumentHistory()— går gjennom hver endring fra opprettelsen til nåværende tilstand, i kronologisk rekkefølge- Metadata om forfatteren — hver endring inneholder tidsstempelet og den offentlige signeringsnøkkelen til brukeren som gjorde den
- Uavhengige kopier — hver dokumentversjon som leveres, er et selvstendig øyeblikksbilde du trygt kan lagre og sammenligne
- Endringsdeteksjon — leverer bare når dokumentet faktisk er endret (oppdateringer uten virkning hoppes over)
Lag egne databaseinstanser synkronisert til en hvilken som helst dato
Fordi synkroniseringsprotokollen i MindooDB overfører enkeltendringer med tidsstempel, kan du opprette en ny databaseinstans og bare synkronisere den fram til et bestemt tidspunkt. Det gir deg et fryst øyeblikksbilde av databasen slik den var da — nyttig til revisjoner fra myndigheter, reproduserbare analyser eller sammenligning av datatilstanden over ulike tidsrom. Append-only-lageret sørger for at øyeblikksbildet er fullstendig og manipulasjonssikkert.
Lag en fryst kopi av databasen ved utgangen av hvert regnskapskvartal. Revisorer kan uavhengig kontrollere dokumenttilstander, signaturer på opphav og endringshistorikk — alt kryptografisk beviselig.
Sammenlign dokumentmengder på to tidsstempler for å finne hva som ble opprettet, endret eller slettet imellom. Kombinert med getDocumentAtTimestamp() ser du nøyaktig hvordan enkeltdokumenter har utviklet seg.
Kjør den samme virtuelle visningen eller spørringen mot øyeblikksbilder av databasen på ulike datoer. Sammenlign resultatene fra måned til måned eller fra kvartal til kvartal uten å vedlikeholde egne rapporteringsdatabaser.
Mønstre til å kopiere
Utdragene er hentet fra dokumentasjonen og testsuiten til MindooDB, så de holder seg til reelle bruksmønstre.
Hvordan inkrementell indeksering passer inn i MindooDB-arkitekturen
I MindooDB er dokumentinnholdet ende-til-ende-kryptert. Serveren lagrer bare chiffertekst og kan ikke kjøre spørringer. Det er en bevisst avveining for sikkerheten: konfidensialitet foran bekvemmelighet på serversiden. Indeksering på klientsiden gir deg tilbake de spørringsmulighetene du forventer — med garantien om at dataene dine aldri ligger åpne for serveren.
Den inkrementelle tilnærmingen holder dette praktisk også i stor skala. I stedet for å bygge indeksene på nytt etter hver synkronisering fortsetter cursoren nøyaktig der den slapp og behandler bare deltaet. I en database med 100 000 dokumenter der 50 er endret siden forrige synkronisering, behandler indekseren 50 dokumenter — ikke 100 000.
Append-only-lageret i MindooDB er det som gjør alle disse mønstrene mulige. Fordi endringer aldri overskrives:
- Cursorene er stabile — endringsrekkefølgen endrer seg ikke, så det er alltid konsistent å fortsette fra en cursor
- Tidsreise koster ingenting ekstra — hele historikken ligger der allerede; ingen ekstra logging eller øyeblikksbilder trengs
- Revisjonsspor er innebygd — hver endring signeres og tidsstemples av den som gjorde den
- Inkrementelle oppdateringer er korrekte — endringsstrømmen er fullstendig og ordnet; ingen oppdateringer går tapt
Det står i kontrast til foranderlige databaser, der endringssporing, historikk og inkrementell indeksering krever ekstra infrastruktur (WAL, CDC, endringsstrømmer, revisjonstabeller).