Odpytuj wszystko. Nie przetwarzaj niczego drugi raz.
Magazyn append-only w MindooDB i śledzenie zmian kursorem pozwalają budować indeksy, które pozostają aktualne, bo przetwarzają wyłącznie to, co się zmieniło — bez ponownego skanowania całej bazy danych. To samo prymitywne narzędzie napędza widoki wirtualne, wyszukiwanie pełnotekstowe, synchronizację z zewnętrznymi systemami i zapytania o przeszłe stany.
Dlaczego indeksowanie przyrostowe ma znaczenie
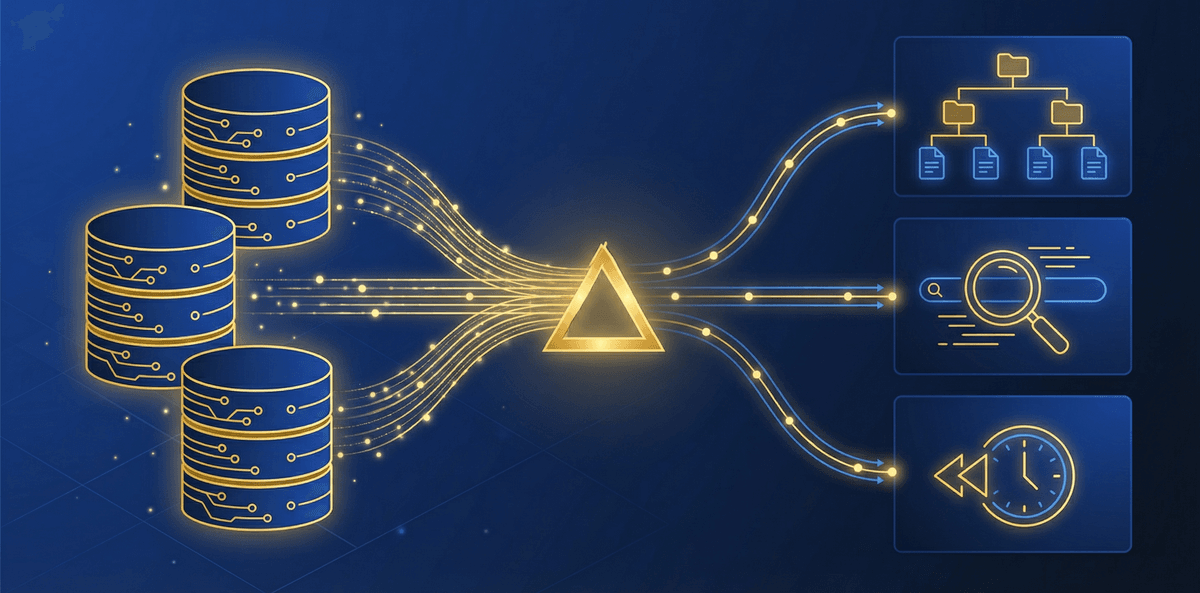
W bazach danych szyfrowanych end-to-end serwer nie wykona zapytań — wszystkie dane to szyfrogram. MindooDB rozwiązuje to przyrostowym indeksowaniem po stronie klienta: jedną opartą na kursorze API, która przetwarza tylko zmienione dokumenty. Niesie ona wszystko, od hierarchicznych zestawień, przez wyszukiwanie pełnotekstowe, po audyty zgodności — i nigdy nie wymaga pełnego skanu bazy. Efektem jest przewidywalna wydajność, która skaluje się z tempem zmian, a nie z ilością danych.
iterateChangesSince() to wspólny fundament widoków wirtualnych, wyszukiwania pełnotekstowego, synchronizacji z zewnętrznymi systemami i własnych analiz. Poznaj jedną API, odblokuj wszystkie wzorce odpytywania.
Widoki wirtualne obejmują wiele baz danych w jednym tenancie, sięgają ponad tenanty albo mieszają dane lokalne i zdalne — bez przenoszenia dokumentów. Idealne do skonsolidowanych pulpitów i raportowania ponad organizacjami.
Magazyn append-only zachowuje każdą zmianę. Odpytuj dowolny przeszły stan, porównuj, jak dokumenty zmieniały się w czasie, twórz migawki bazy danych na dany moment i buduj pełne ścieżki audytu — wszystko z tych samych danych.
iterateChangesSince() — przetwarzaj tylko to, co się zmieniło
Każda strategia odpytywania w MindooDB zaczyna się od tego samego prymitywu: opartego na kursorze generatora asynchronicznego, który wydaje dokumenty w kolejności ich zmian. Przy pierwszym wywołaniu przechodzi całą bazę danych; przy kolejnych podejmuje dokładnie tam, gdzie skończył. Usunięte dokumenty przychodzą ze znacznikiem usunięcia, więc indeksy po drugiej stronie mogą posprzątać. Koszt każdego przebiegu jest proporcjonalny do liczby zmian od ostatniego kursora — nie do wielkości całej bazy.
- Oparte na kursorze — przy pierwszym skanie przekaż
null, a przy przyrostowych aktualizacjach ostatnio zwrócony kursor - Kolejność zmian — dokumenty przychodzą od najstarszej zmiany, więc indeksy widzą spójny przebieg
- Świadome usunięć — usunięte dokumenty pojawiają się z flagą
isDeleted()i dają się czysto usunąć z indeksów - Porcjowanie po stronie odbiorcy — generator asynchroniczny pozwala zatrzymać się w dowolnym momencie i wznowić później
- O(changed) — każdy przyrostowy przebieg przetwarza tylko dokumenty zmienione od ostatniego kursora
- Żadnych pełnych skanów — wewnętrzny indeks prowadzi
(lastModified, docId), żeby kursor wznawiał się wydajnie - Wymienni odbiorcy — jeden strumień zmian może w jednym przebiegu zasilić wiele indekserów
- Działa offline — indeksy aktualizują się lokalnie; synchronizacja przynosi zdalne zmiany, a potem indeksery przetwarzają deltę
Hierarchiczne widoki z kategoriami, sortowaniem i sumami
Widoki wirtualne układają dokumenty w strukturę drzewa w pamięci — pomyśl o dynamicznym spisie treści, który kategoryzuje, sortuje i agreguje Twoje dane. Wzorowane na sprawdzonym paradygmacie widoków z HCL Notes/Domino, obsługują zagnieżdżone hierarchie kategorii, sortowanie rosnące i malejące po wielu kolumnach oraz wbudowane agregacje SUM i AVERAGE na wierszach kategorii. Aktualizacje są przyrostowe: gdy dokument się zmienia, widok odświeża tylko dotknięte gałęzie.
- Kolumny kategorii — grupują dokumenty w zagnieżdżone hierarchie (np. Dział > Rok > Kwartał)
- Kolumny sortujące — porządkują wpisy wewnątrz każdej kategorii po jednym lub kilku polach
- Kolumny sum — automatyczne SUM albo AVERAGE dla każdej kategorii, aktualizowane przyrostowo
- Kolumny wyświetlane — dodatkowe dane pokazywane przy każdym wpisie
- Funkcje wartości — wyliczają wartości kolumn dynamicznie z danych dokumentu
- Rozwijanie i zwijanie — wchodź w kategorie albo je zamykaj, jak w menedżerze plików
- Nawigacja po pozycji — skocz do „1.2.3” (pierwsza kategoria, druga podkategoria, trzeci wpis)
- Zaznaczanie — wybieraj pojedyncze wpisy albo całe kategorie do operacji masowych
- Callbacki kontroli dostępu — filtruj widoczne wpisy dla każdego użytkownika, nie zmieniając struktury widoku
- Iteracja w przód i w tył — przechodź drzewo w obu kierunkach
Jeden widok, wiele baz danych — także ponad tenantami
Jedną z najmocniejszych cech widoków wirtualnych jest możliwość połączenia dokumentów z wielu instancji MindooDB w jeden, wspólny widok. Każde źródło danych jest identyfikowane łańcuchem „origin”, więc zawsze wiadomo, z której bazy danych (i z którego tenanta) pochodzi dokument. Dzięki temu bez trudu zbudujesz skonsolidowane pulpity, raporty ponad regionami i analizy ponad organizacjami — bez przenoszenia i duplikowania danych.
Połącz bazę produktów z USA i bazę produktów z UE w jeden katalog produktów. Widok kategoryzuje i sortuje w poprzek obu źródeł. Każdy wpis niesie swój origin, więc interfejs może pokazać region pochodzenia.
Rozepnij widoki na różne obiekty MindooTenant, żeby raportować ponad organizacjami. Dwie organizacje dzielą dane w trzecim tenancie; skonsolidowany widok agreguje przychód z wszystkich trzech — a każdy tenant zachowuje własną administrację.
Każdy dostawca danych prowadzi własny kursor niezależnie. Wywołanie view.update() przetwarza tylko te dokumenty, które zmieniły się w danym źródle od ostatniego przebiegu. Pojedynczy origin odświeżysz też przez view.updateOrigin("us-products").
Wysyłaj przyrostowe aktualizacje do dowolnego indeksera i potoku
To samo prymitywne iterateChangesSince(), które napędza widoki wirtualne, zasili każdy zewnętrzny system. Utrzymuj nim aktualny indeks wyszukiwania pełnotekstowego, przekazuj zmiany do potoku analitycznego albo replikuj dane do usługi zewnętrznej. Ponieważ kursor dokładnie pamięta, które dokumenty zostały już przetworzone, integracja nie przegapi żadnej zmiany i nie przetworzy niczego niepotrzebnie drugi raz.
Wyszukiwanie pełnotekstowe po stronie klienta to naturalne dopełnienie szyfrowania end-to-end — i MindooDB ma je od razu w zestawie: włączany opcjonalnie, utrzymywany przez changefeed indeks pełnotekstowy (na bazie MiniSearch), który jest przechowywany w postaci zaszyfrowanej i wchodzi wprost w zapytania, z wynikami sortowanymi po trafności.
- Różnorodne treści — zwykły tekst, pola tekstowe Automerge, fragmenty rich text, tekst z załączników (PDF/Office)
- Integracja z zapytaniami — łącz trafienia pełnotekstowe ze strukturalnymi filtrami i sortowaniem po trafności
- Świadome języka — tokenizacja przez
Intl.Segmenter, konfigurowalna osobno dla każdej bazy danych - Zewnętrzne indeksery — FlexSearch, Lunr.js i własne systemy dalej podłączysz przez changefeed
Buduj potoki danych, które reagują na zmiany dokumentów. Wzorzec generatora asynchronicznego pozwala przetwarzać zmiany we własnym tempie, z wbudowanym mechanizmem przeciwciśnienia.
- Zasilanie analityki — wysyłaj zagregowane wskaźniki na pulpity
- Wyzwalacze webhook — powiadamiaj zewnętrzne systemy, gdy zmienią się konkretne dokumenty
- Potoki ETL — wyciągaj i przekształcaj dane dla systemów raportowych
- Replikacja — odwzoruj dane w systemach wtórnych z semantyką exactly-once
Menedżer indeksów może sterować wieloma indekserami z jednego strumienia zmian. Każdy zmieniony dokument jest przetwarzany raz, a aktualizacje trafiają w jednym przebiegu do wszystkich zarejestrowanych indeksów — widoków wirtualnych, wyszukiwania pełnotekstowego, analityki i własnych odbiorców. Każdy indekser prowadzi własny stan, więc dodanie albo przebudowa jednego z nich nie dotyka pozostałych.
Odpytuj przeszłość, porównuj zmiany, buduj ścieżki audytu
Magazyn append-only w MindooDB zachowuje każdą zmianę dokumentu. Daje to trzy mocne możliwości: pobranie dokumentu z dowolnego historycznego znacznika czasu, przejście pełnej historii zmian dokumentu i wypisanie wszystkich dokumentów, które istniały w danej chwili. Razem niosą audyty zgodności, porównywanie wersji, cofanie i ponawianie zmian oraz migawki bazy danych na dany moment.
getDocumentAtTimestamp()— pobiera migawkę dokumentu z dowolnego przeszłego znacznika czasu, wraz ze wszystkimi zmianami do tej chwiligetAllDocumentIdsAtTimestamp()— wydajnie zwraca identyfikatory wszystkich dokumentów, które istniały w danej chwili, bez wczytywania treści- Obsługa usuniętych dokumentów — odróżnia „jeszcze nie istniał” (zwraca
null) od „został usunięty” (zwraca dokument z flagąisDeleted())
iterateDocumentHistory()— przechodzi każdą zmianę od utworzenia do stanu bieżącego, w kolejności chronologicznej- Metadane autora — każda zmiana zawiera znacznik czasu i publiczny klucz podpisujący użytkownika, który ją wprowadził
- Niezależne kopie — każda wydana wersja dokumentu to samodzielna migawka, którą można bezpiecznie zapisać i porównać
- Wykrywanie zmian — wydaje wynik tylko wtedy, gdy dokument faktycznie się zmienił (aktualizacje bez skutku są pomijane)
Twórz osobne instancje bazy danych zsynchronizowane na dowolną datę
Ponieważ protokół synchronizacji MindooDB przenosi pojedyncze wpisy zmian wraz ze znacznikami czasu, możesz założyć nową instancję bazy danych i zsynchronizować ją tylko do określonego momentu. Powstaje z tego zamrożona migawka bazy z tej chwili — przydatna przy audytach regulacyjnych, w odtwarzalnych analizach i przy porównywaniu stanu danych między okresami. Magazyn append-only gwarantuje, że migawka jest kompletna i odporna na manipulacje.
Twórz zamrożoną kopię bazy danych na koniec każdego kwartału obrotowego. Audytorzy mogą niezależnie zweryfikować stany dokumentów, podpisy autorstwa i historię zmian — wszystko jest kryptograficznie dowodliwe.
Zestaw dokumenty z dwóch znaczników czasu, żeby zobaczyć, co w międzyczasie powstało, zmieniło się albo zostało usunięte. W połączeniu z getDocumentAtTimestamp() prześledzisz dokładnie, jak zmieniały się pojedyncze dokumenty.
Uruchom ten sam widok wirtualny albo to samo zapytanie na migawkach bazy danych z różnych dat. Porównuj wyniki miesiąc do miesiąca albo kwartał do kwartału, bez utrzymywania osobnych baz raportowych.
Wzorce do skopiowania
Te fragmenty pochodzą z dokumentacji MindooDB i z zestawu testów, żeby odpowiadały rzeczywistym wzorcom użycia.
Jak indeksowanie przyrostowe wpisuje się w architekturę MindooDB
W MindooDB treść dokumentów jest szyfrowana end-to-end. Serwer przechowuje wyłącznie szyfrogram i nie wykona zapytań. To świadomy kompromis na rzecz bezpieczeństwa: poufność przed wygodą po stronie serwera. Indeksowanie na kliencie przywraca oczekiwane możliwości odpytywania — z gwarancją, że Twoje dane nigdy nie odsłaniają się przed serwerem.
Podejście przyrostowe utrzymuje to w praktyce także przy dużej skali. Zamiast przebudowywać indeksy od zera po każdej synchronizacji, kursor podejmuje dokładnie tam, gdzie skończył, i przetwarza samą deltę. Przy bazie ze 100 000 dokumentów, z których od ostatniej synchronizacji zmieniło się 50, indekser przetwarza 50 dokumentów — nie 100 000.
Magazyn append-only w MindooDB jest tym, co w ogóle umożliwia wszystkie te wzorce. Ponieważ zmiany nigdy nie są nadpisywane:
- Kursory są stabilne — kolejność zmian się nie zmienia, więc wznowienie od kursora jest zawsze spójne
- Podróż w czasie nic nie kosztuje — pełna historia już jest zapisana; dodatkowe logi ani migawki nie są potrzebne
- Ścieżki audytu są wbudowane — każda zmiana jest podpisana przez autora i opatrzona znacznikiem czasu
- Przyrostowe aktualizacje są poprawne — strumień zmian jest kompletny i uporządkowany; żadna aktualizacja nie ginie
Stoi to w kontraście do baz danych z nadpisywaniem, w których śledzenie zmian, historia i indeksowanie przyrostowe wymagają dodatkowej infrastruktury (WAL, CDC, strumienie zmian, tabele audytowe).