Alles abfragen. Nichts neu verarbeiten.
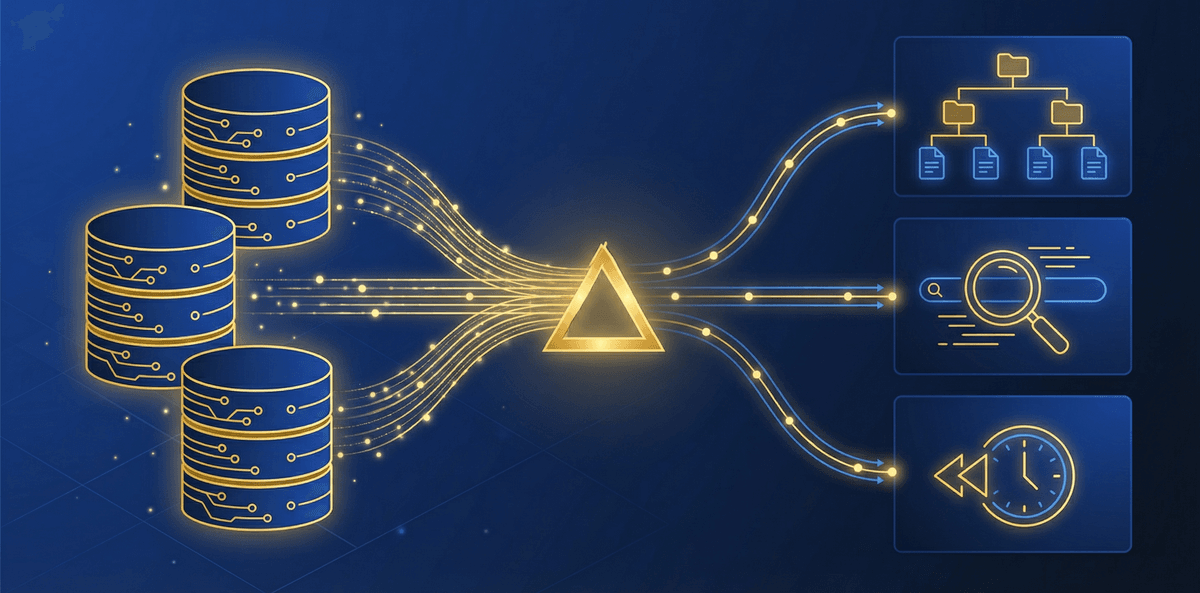
Der Append-only-Store von MindooDB und die cursorbasierte Änderungsverfolgung ermöglichen Indizes, die aktuell bleiben, indem nur Änderungen verarbeitet werden — ohne die gesamte Datenbank erneut zu durchsuchen. Dasselbe Primitiv trägt virtuelle Ansichten, Volltextsuche, Sync mit externen Systemen und Time-Travel-Abfragen.
Warum inkrementelle Indexierung wichtig ist
In Ende-zu-Ende-verschlüsselten Datenbanken kann der Server keine Abfragen ausführen — alle Daten sind Geheimtext. MindooDB löst das mit clientseitiger inkrementeller Indexierung: eine einzige cursorbasierte API, die nur geänderte Dokumente verarbeitet. Sie trägt alles von hierarchischen Auswertungsansichten über Volltextsuche bis zu Compliance-Audits, ohne dass je ein vollständiger Datenbank-Scan nötig wird. Das Ergebnis ist vorhersagbare Performance, die mit der Änderungsrate skaliert, nicht mit der Datenmenge.
iterateChangesSince() ist die gemeinsame Grundlage für virtuelle Ansichten, Volltextsuche, Sync mit externen Systemen und eigene Analysen. Eine API lernen, alle Abfragemuster nutzen.
Virtuelle Ansichten spannen sich über mehrere Datenbanken innerhalb eines Tenants, über Tenants hinweg oder mischen lokale und entfernte Daten — ohne Dokumente zu verschieben. Ideal für konsolidierte Dashboards und organisationsübergreifende Auswertungen.
Der Append-only-Store bewahrt jede Änderung. Frage jeden früheren Stand ab, vergleiche die Entwicklung von Dokumenten über die Zeit, erstelle Datenbank-Snapshots zu einem Stichtag und baue lückenlose Audit-Trails — alles aus denselben Daten.
iterateChangesSince() — nur Änderungen verarbeiten
Jede Abfragestrategie in MindooDB beginnt mit demselben Primitiv: einem cursorbasierten asynchronen Generator, der Dokumente in der Reihenfolge ihrer Änderung liefert. Beim ersten Aufruf durchläuft er die gesamte Datenbank; bei jedem weiteren Aufruf setzt er genau dort fort, wo er aufgehört hat. Gelöschte Dokumente werden mit einer Löschmarkierung mitgeliefert, damit nachgelagerte Indizes aufräumen können. Der Aufwand jedes Laufs ist proportional zur Zahl der Änderungen seit dem letzten Cursor — nicht zur Gesamtgröße der Datenbank.
- Cursorbasiert — für den ersten Durchlauf
nullübergeben, danach den zuletzt zurückgegebenen Cursor für inkrementelle Updates - Änderungsreihenfolge — Dokumente kommen mit der ältesten Änderung zuerst, Indizes sehen also einen konsistenten Verlauf
- Löschungen inklusive — gelöschte Dokumente erscheinen mit
isDeleted()-Flag und lassen sich sauber aus Indizes entfernen - Batching durch den Consumer — der asynchrone Generator lässt sich jederzeit anhalten und später fortsetzen
- O(changed) — jeder inkrementelle Lauf verarbeitet nur Dokumente, die sich seit dem letzten Cursor geändert haben
- Keine Full Scans — der interne Index führt
(lastModified, docId)mit, damit der Cursor effizient fortsetzen kann - Austauschbare Consumer — ein Änderungsstrom kann mehrere Indexer in einem Durchlauf versorgen
- Funktioniert offline — Indizes werden lokal aktualisiert; Sync holt entfernte Änderungen, danach verarbeiten die Indexer das Delta
Hierarchische Ansichten mit Kategorien, Sortierung und Summen
Virtuelle Ansichten ordnen Dokumente in einer Baumstruktur im Arbeitsspeicher an — vergleichbar mit einem dynamischen Inhaltsverzeichnis, das deine Daten kategorisiert, sortiert und aggregiert. Angelehnt an das bewährte View-Paradigma aus HCL Notes/Domino unterstützen sie verschachtelte Kategoriehierarchien, auf- und absteigende Sortierung über mehrere Spalten sowie eingebaute SUM- und AVERAGE-Aggregationen auf Kategoriezeilen. Updates laufen inkrementell: Ändert sich ein Dokument, aktualisiert die Ansicht nur die betroffenen Zweige.
- Kategoriespalten — gruppieren Dokumente in verschachtelten Hierarchien (z. B. Abteilung > Jahr > Quartal)
- Sortierspalten — sortieren Einträge innerhalb jeder Kategorie nach einem oder mehreren Feldern
- Summenspalten — automatisch SUM oder AVERAGE je Kategorie, inkrementell aktualisiert
- Anzeigespalten — zusätzliche Daten neben jedem Eintrag
- Wertfunktionen — berechnen Spaltenwerte dynamisch aus den Dokumentdaten
- Auf- und Zuklappen — Kategorien öffnen oder schließen, wie in einem Dateimanager
- Positionsbasierte Navigation — direkt zu „1.2.3“ springen (erste Kategorie, zweite Unterkategorie, dritter Eintrag)
- Auswahl — einzelne Einträge oder ganze Kategorien für Massenoperationen auswählen
- Callbacks für die Zugriffskontrolle — sichtbare Einträge je Benutzer filtern, ohne die Struktur der Ansicht zu ändern
- Iteration vorwärts und rückwärts — den Baum in beide Richtungen durchlaufen
Eine Ansicht, viele Datenbanken — auch über Tenants hinweg
Eine der stärksten Eigenschaften virtueller Ansichten ist die Möglichkeit, Dokumente aus mehreren MindooDB-Instanzen in einer einzigen, einheitlichen Ansicht zusammenzuführen. Jede Datenquelle wird über eine „origin“-Zeichenkette identifiziert, sodass immer klar ist, aus welcher Datenbank (und welchem Tenant) ein Dokument stammt. Damit lassen sich konsolidierte Dashboards, regionenübergreifende Berichte und organisationsübergreifende Auswertungen unkompliziert umsetzen — ohne Daten zu verschieben oder zu duplizieren.
Führe eine US-Produktdatenbank und eine EU-Produktdatenbank zu einem einzigen Produktkatalog zusammen. Die Ansicht kategorisiert und sortiert über beide Quellen hinweg. Jeder Eintrag trägt seinen Origin, sodass die Oberfläche die Herkunftsregion anzeigen kann.
Spanne Ansichten über verschiedene MindooTenants für organisationsübergreifende Auswertungen. Zwei Organisationen teilen Daten in einem dritten Tenant; eine konsolidierte Ansicht aggregiert den Umsatz über alle drei — jeder Tenant behält seine eigene Administration.
Jeder Datenprovider führt seinen eigenen Cursor unabhängig mit. Ein Aufruf von view.update() verarbeitet nur die Dokumente, die sich seit dem letzten Lauf in der jeweiligen Quelle geändert haben. Mit view.updateOrigin("us-products") lässt sich auch ein einzelner Origin aktualisieren.
Inkrementelle Updates an jeden Indexer und jede Pipeline schicken
Dasselbe Primitiv iterateChangesSince(), das virtuelle Ansichten trägt, kann jedes externe System versorgen. Halte damit einen Volltextindex aktuell, schiebe Änderungen in eine Analytics-Pipeline oder repliziere Daten in einen externen Dienst. Weil der Cursor genau festhält, welche Dokumente bereits verarbeitet wurden, verpasst die Integration keine Änderung und verarbeitet nichts unnötig erneut.
Clientseitige Volltextsuche ist die natürliche Ergänzung zur Ende-zu-Ende-Verschlüsselung — und MindooDB bringt sie von Haus aus mit: ein optional aktivierbarer, über den Changefeed gepflegter Volltextindex (auf Basis von MiniSearch), der verschlüsselt gespeichert wird und sich mit relevanzsortierten Ergebnissen direkt in Abfragen einfügt.
- Vielfältige Inhalte — einfacher Text, Automerge-Textfelder, Rich-Text-Abschnitte, Text aus Anhängen (PDF/Office)
- Abfrageintegration — Volltexttreffer mit strukturierten Filtern und Relevanzsortierung kombinieren
- Sprachbewusst — Tokenisierung über
Intl.Segmenter, pro Datenbank konfigurierbar - Externe Indexer — FlexSearch, Lunr.js oder eigene Systeme bleiben über den Changefeed anschließbar
Baue Datenpipelines, die auf Dokumentänderungen reagieren. Durch das Async-Generator-Muster verarbeitest du Änderungen im eigenen Tempo, Backpressure inklusive.
- Analytics-Feeds — aggregierte Kennzahlen an Dashboards schicken
- Webhook-Trigger — externe Systeme benachrichtigen, wenn sich bestimmte Dokumente ändern
- ETL-Pipelines — Daten für Reporting-Systeme extrahieren und transformieren
- Replikation — Daten mit Exactly-once-Semantik in Sekundärsysteme spiegeln
Ein Index-Manager kann mehrere Indexer aus einem einzigen Änderungsstrom koordinieren. Jedes geänderte Dokument wird einmal verarbeitet, und die Updates gehen in einem Durchlauf an alle registrierten Indizes — virtuelle Ansichten, Volltextsuche, Analytics und eigene Consumer. Jeder Indexer führt seinen eigenen Stand mit, das Hinzufügen oder der Neuaufbau eines Indexers betrifft die anderen also nicht.
Vergangenheit abfragen, Änderungen vergleichen, Audit-Trails aufbauen
Der Append-only-Store von MindooDB bewahrt jede Dokumentänderung. Daraus ergeben sich drei starke Möglichkeiten: ein Dokument zu einem beliebigen historischen Zeitstempel abrufen, die vollständige Änderungshistorie eines Dokuments durchlaufen und alle Dokumente auflisten, die zu einem bestimmten Zeitpunkt existierten. Zusammen tragen sie Compliance-Audits, Versionsvergleiche, Undo/Redo und Datenbank-Snapshots zu einem Stichtag.
getDocumentAtTimestamp()— liefert den Stand eines Dokuments zu einem beliebigen früheren Zeitstempel, inklusive aller Änderungen bis zu diesem MomentgetAllDocumentIdsAtTimestamp()— liefert effizient alle Dokument-IDs, die zu einem bestimmten Zeitpunkt existierten, ohne Inhalte zu laden- Umgang mit gelöschten Dokumenten — unterscheidet zwischen „existierte noch nicht“ (liefert
null) und „wurde gelöscht“ (liefert das Dokument mitisDeleted()-Flag)
iterateDocumentHistory()— durchläuft jede Änderung von der Erstellung bis zum aktuellen Stand, in chronologischer Reihenfolge- Autor-Metadaten — jede Änderung enthält den Zeitstempel und den öffentlichen Signaturschlüssel des Benutzers, der sie vorgenommen hat
- Unabhängige Kopien — jede gelieferte Dokumentversion ist ein eigenständiger Stand, den du gefahrlos speichern und vergleichen kannst
- Änderungserkennung — liefert nur, wenn sich das Dokument tatsächlich geändert hat (Updates ohne Wirkung werden übersprungen)
Eigene Datenbankinstanzen, synchronisiert auf ein beliebiges Datum
Weil das Sync-Protokoll von MindooDB einzelne Änderungseinträge mit Zeitstempel überträgt, kannst du eine neue Datenbankinstanz anlegen und nur bis zu einem bestimmten Zeitpunkt synchronisieren. Das ergibt einen eingefrorenen Stand der Datenbank zu diesem Moment — nützlich für regulatorische Audits, reproduzierbare Auswertungen oder den Vergleich von Datenständen über Zeiträume hinweg. Der Append-only-Store stellt sicher, dass der Snapshot vollständig und manipulationssicher ist.
Lege zum Ende jedes Geschäftsquartals eine eingefrorene Kopie deiner Datenbank an. Prüfer können Dokumentstände, Signaturen zur Urheberschaft und Änderungshistorie unabhängig verifizieren — alles kryptografisch belegbar.
Vergleiche Dokumentmengen zu zwei Zeitstempeln, um zu sehen, was dazwischen angelegt, geändert oder gelöscht wurde. In Kombination mit getDocumentAtTimestamp() lässt sich genau nachvollziehen, wie sich einzelne Dokumente entwickelt haben.
Führe dieselbe virtuelle Ansicht oder Abfrage gegen Datenbank-Snapshots zu verschiedenen Stichtagen aus. Vergleiche Ergebnisse von Monat zu Monat oder von Quartal zu Quartal, ohne separate Reporting-Datenbanken zu pflegen.
Muster zum Kopieren
Diese Snippets stammen aus der MindooDB-Dokumentation und der Testsuite, damit sie realen Nutzungsmustern entsprechen.
Wie inkrementelle Indexierung in die MindooDB-Architektur passt
In MindooDB sind Dokumentinhalte Ende-zu-Ende-verschlüsselt. Der Server speichert nur Geheimtext und kann keine Abfragen ausführen. Das ist ein bewusster Trade-off zugunsten der Sicherheit: Vertraulichkeit vor serverseitigem Komfort. Clientseitige Indexierung stellt die gewohnten Abfragemöglichkeiten wieder her — mit der Garantie, dass deine Daten dem Server nie offenliegen.
Der inkrementelle Ansatz hält das auch bei großen Datenmengen praktikabel. Statt die Indizes nach jedem Sync neu aufzubauen, setzt der Cursor genau dort fort, wo er aufgehört hat, und verarbeitet nur das Delta. Bei einer Datenbank mit 100.000 Dokumenten, von denen sich seit dem letzten Sync 50 geändert haben, verarbeitet der Indexer 50 Dokumente — nicht 100.000.
Der Append-only-Store von MindooDB macht all diese Muster erst möglich. Weil Änderungen nie überschrieben werden:
- Cursor sind stabil — die Änderungsreihenfolge ändert sich nicht, das Fortsetzen ab einem Cursor ist also immer konsistent
- Time Travel kostet nichts extra — die vollständige Historie liegt bereits vor; zusätzliches Logging oder Snapshots sind nicht nötig
- Audit-Trails sind eingebaut — jede Änderung wird von ihrem Urheber signiert und mit Zeitstempel versehen
- Inkrementelle Updates sind korrekt — der Änderungsstrom ist vollständig und geordnet; kein Update geht verloren
Das steht im Gegensatz zu veränderbaren Datenbanken, in denen Änderungsverfolgung, Historie und inkrementelle Indexierung zusätzliche Infrastruktur erfordern (WAL, CDC, Change Streams, Audit-Tabellen).