Interroga tutto. Rielabora niente.
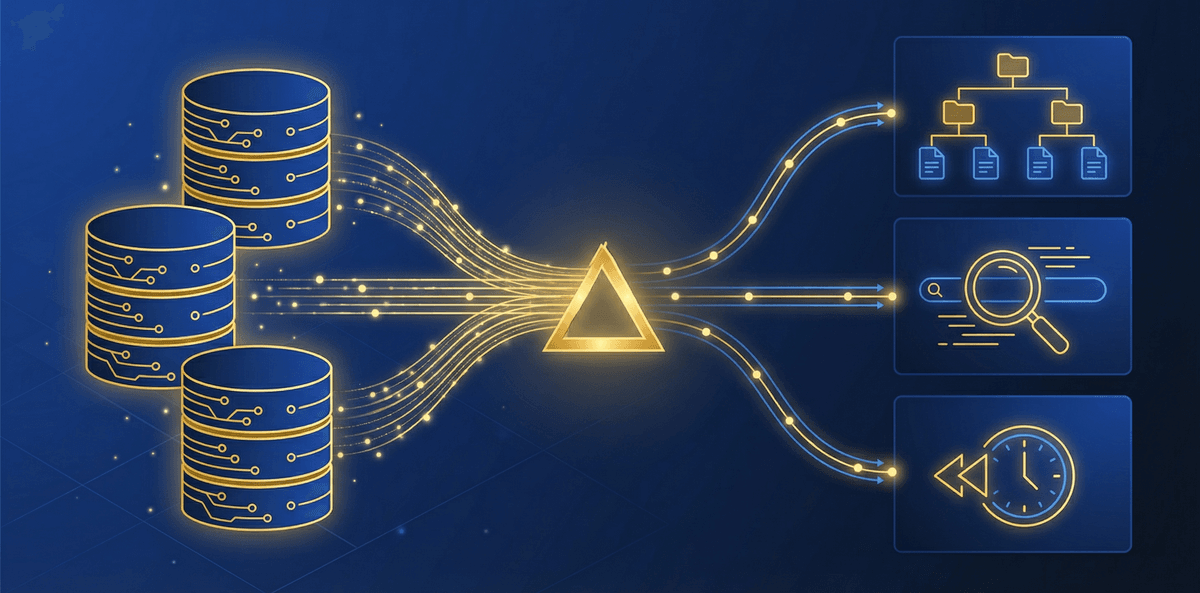
Lo store append-only di MindooDB e il tracciamento delle modifiche basato su cursore permettono di costruire indici che restano aggiornati elaborando solo ciò che è cambiato — senza mai riscandire l'intero database. La stessa primitiva regge viste virtuali, ricerca full-text, sincronizzazione con sistemi esterni e query di viaggio nel tempo.
Perché l'indicizzazione incrementale conta
Nei database cifrati end-to-end il server non può eseguire query — tutti i dati sono testo cifrato. MindooDB risolve il problema con l'indicizzazione incrementale lato client: un'unica API basata su cursore che elabora solo i documenti modificati. Regge tutto, dalle viste di rendicontazione gerarchiche alla ricerca full-text fino agli audit di conformità, senza mai richiedere una scansione completa del database. Il risultato è una performance prevedibile, che scala con il ritmo delle modifiche e non con la quantità di dati.
iterateChangesSince() è l'unica base per viste virtuali, ricerca full-text, sincronizzazione con sistemi esterni e analisi su misura. Impari una sola API e hai accesso a tutti gli schemi di interrogazione.
Le viste virtuali si estendono su più database dentro un tenant, attraverso tenant diversi, oppure mescolano dati locali e remoti — senza spostare documenti. Ideali per dashboard consolidati e rendicontazione tra organizzazioni.
Lo store append-only conserva ogni modifica. Interroga qualsiasi stato passato, confronta l'evoluzione dei documenti nel tempo, crea snapshot del database a una data precisa e costruisci audit trail completi — tutto dagli stessi dati.
iterateChangesSince() — elabora solo ciò che è cambiato
Ogni strategia di interrogazione in MindooDB parte dalla stessa primitiva: un generatore asincrono basato su cursore che restituisce i documenti nell'ordine in cui sono stati modificati. Alla prima chiamata percorre l'intero database; alle chiamate successive riprende esattamente da dove si era fermato. I documenti eliminati arrivano con un contrassegno di eliminazione, così gli indici a valle possono fare pulizia. Il costo di ogni esecuzione è proporzionale al numero di modifiche dall'ultimo cursore — non alla dimensione complessiva del database.
- Basato su cursore — passa
nullper la scansione iniziale, poi l'ultimo cursore restituito per gli aggiornamenti incrementali - Ordine di modifica — i documenti arrivano dalla modifica più vecchia in avanti, così gli indici vedono una progressione coerente
- Attento alle eliminazioni — i documenti eliminati compaiono con il flag
isDeleted(), per rimuoverli in modo pulito dagli indici - Batch guidato dal consumer — il generatore asincrono si può fermare in qualsiasi punto e riprendere più tardi
- O(changed) — ogni esecuzione incrementale elabora solo i documenti modificati dall'ultimo cursore
- Nessuna scansione completa — l'indice interno tiene traccia di
(lastModified, docId), così il cursore riprende in modo efficiente - Consumer sostituibili — un solo flusso di modifiche può alimentare più indicizzatori in un'unica passata
- Funziona offline — gli indici si aggiornano in locale; la sincronizzazione porta le modifiche remote e gli indicizzatori elaborano il delta
Viste gerarchiche con categorie, ordinamento e totali
Le viste virtuali organizzano i documenti in una struttura ad albero in memoria — come un sommario dinamico che categorizza, ordina e aggrega i tuoi dati. Ispirate al collaudato paradigma delle viste di HCL Notes/Domino, supportano gerarchie di categorie annidate, ordinamento crescente e decrescente su più colonne e aggregazioni SUM e AVERAGE integrate sulle righe di categoria. Gli aggiornamenti sono incrementali: quando un documento cambia, la vista aggiorna solo i rami interessati.
- Colonne di categoria — raggruppano i documenti in gerarchie annidate (per esempio Reparto > Anno > Trimestre)
- Colonne ordinate — ordinano le voci dentro ogni categoria per uno o più campi
- Colonne di totale — SUM o AVERAGE automatica per categoria, aggiornata in modo incrementale
- Colonne di visualizzazione — dati aggiuntivi mostrati accanto a ogni voce
- Funzioni di valore — calcolano i valori di colonna al volo dai dati del documento
- Espandi e comprimi — entra nelle categorie o richiudile, come in un gestore di file
- Navigazione per posizione — salta a "1.2.3" (prima categoria, seconda sottocategoria, terza voce)
- Selezione — seleziona singole voci o intere categorie per operazioni di massa
- Callback per il controllo degli accessi — filtrano le voci visibili per ogni utente senza cambiare la struttura della vista
- Iterazione in avanti e all'indietro — percorri l'albero nelle due direzioni
Una vista, molti database — anche tra tenant diversi
Una delle capacità più forti delle viste virtuali è unire documenti provenienti da più istanze MindooDB in un'unica vista coerente. Ogni sorgente di dati è identificata da una stringa "origin", quindi sai sempre da quale database (e da quale tenant) arriva un documento. Così diventa semplice costruire dashboard consolidati, report tra regioni e analisi tra organizzazioni — senza spostare né duplicare i dati.
Unisci un database di prodotti statunitense e uno europeo in un unico catalogo. La vista categorizza e ordina attraverso entrambe le sorgenti. Ogni voce porta con sé il suo origin, così l'interfaccia può mostrare la regione di provenienza.
Estendi le viste su MindooTenant diversi, per rendicontare tra organizzazioni. Due organizzazioni condividono dati in un terzo tenant; una vista consolidata aggrega i ricavi di tutti e tre — e ogni tenant mantiene la propria amministrazione indipendente.
Ogni fornitore di dati tiene il proprio cursore in modo indipendente. Una chiamata a view.update() elabora solo i documenti cambiati in ciascuna sorgente dall'ultima esecuzione. Con view.updateOrigin("us-products") puoi anche aggiornare un singolo origin.
Aggiornamenti incrementali a ogni indicizzatore o pipeline
La stessa primitiva iterateChangesSince() che regge le viste virtuali può alimentare qualsiasi sistema esterno. Usalo per tenere aggiornato un indice di ricerca full-text, per spingere le modifiche in una pipeline di analisi o per replicare i dati verso un servizio esterno. Poiché il cursore registra con precisione quali documenti sono già stati elaborati, l'integrazione non perde mai una modifica e non rielabora dati inutilmente.
La ricerca full-text lato client è il complemento naturale della cifratura end-to-end — e MindooDB la porta con sé: un indice full-text attivabile a scelta e mantenuto dal changefeed (basato su MiniSearch), conservato cifrato a riposo e integrato direttamente nelle query, con risultati ordinati per pertinenza.
- Contenuti di ogni tipo — testo semplice, campi di testo Automerge, porzioni di rich text, testo degli allegati (PDF/Office)
- Integrazione nelle query — combina la corrispondenza full-text con filtri strutturati e ordinamento per pertinenza
- Consapevole della lingua — tokenizzazione con
Intl.Segmenter, configurabile per ogni database - Indicizzatori esterni — FlexSearch, Lunr.js o sistemi propri restano collegabili tramite il changefeed
Costruisci pipeline di dati che reagiscono alle modifiche dei documenti. Lo schema del generatore asincrono ti permette di elaborare le modifiche al tuo ritmo, con la backpressure già inclusa.
- Feed di analisi — mandano metriche aggregate ai dashboard
- Trigger webhook — avvisano i sistemi esterni quando cambiano documenti precisi
- Pipeline ETL — estraggono e trasformano i dati per i sistemi di rendicontazione
- Replica — rispecchia i dati su sistemi secondari con semantica exactly-once
Un gestore di indici può coordinare più indicizzatori da un unico flusso di modifiche. Ogni documento modificato viene elaborato una sola volta e gli aggiornamenti raggiungono tutti gli indici registrati — viste virtuali, ricerca full-text, analisi e consumer su misura — in una sola passata. Ogni indicizzatore tiene il proprio stato, quindi aggiungerne uno o ricostruirlo non tocca gli altri.
Interroga il passato, confronta le modifiche, costruisci audit trail
Lo store append-only di MindooDB conserva ogni modifica dei documenti. Ne derivano tre possibilità importanti: recuperare un documento a una qualsiasi marca temporale passata, percorrere l'intera cronologia delle modifiche di un documento ed elencare tutti i documenti esistenti in un preciso momento. Insieme reggono gli audit di conformità, il confronto tra versioni, l'annulla/ripeti e gli snapshot del database a una data precisa.
getDocumentAtTimestamp()— recupera lo snapshot di un documento a una qualsiasi marca temporale passata, applicando tutte le modifiche fino a quel momentogetAllDocumentIdsAtTimestamp()— ottiene in modo efficiente tutti gli ID dei documenti esistenti in un preciso momento, senza caricarne il contenuto- Gestione dei documenti eliminati — distingue tra "non esisteva ancora" (restituisce
null) e "è stato eliminato" (restituisce il documento con il flagisDeleted())
iterateDocumentHistory()— percorre ogni modifica dalla creazione allo stato attuale, in ordine cronologico- Metadati dell'autore — ogni modifica porta la marca temporale e la chiave pubblica di firma dell'utente che l'ha fatta
- Copie indipendenti — ogni versione restituita è uno snapshot a sé, che puoi conservare e confrontare senza rischi
- Rilevamento delle modifiche — restituisce solo se il documento è cambiato davvero (salta gli aggiornamenti a vuoto)
Crea istanze di database separate, sincronizzate a una data qualsiasi
Poiché il protocollo di sincronizzazione di MindooDB trasferisce singole voci di modifica con la loro marca temporale, puoi creare una nuova istanza di database e sincronizzarla solo fino a un preciso momento. Ne esce uno snapshot congelato del database a quell'istante — utile per gli audit regolamentari, per analisi riproducibili o per confrontare lo stato dei dati tra periodi diversi. Lo store append-only garantisce che lo snapshot sia completo e a prova di manomissione.
Crea una copia congelata del database alla fine di ogni trimestre fiscale. I revisori possono verificare in modo indipendente lo stato dei documenti, le firme di paternità e la cronologia delle modifiche — tutto dimostrabile crittograficamente.
Confronta gli insiemi di documenti a due marche temporali per scoprire cosa è stato creato, modificato o eliminato nel frattempo. In combinazione con getDocumentAtTimestamp() vedi esattamente come si sono evoluti i singoli documenti.
Esegui la stessa vista virtuale o la stessa query su snapshot del database a date diverse. Confronta i risultati mese su mese o trimestre su trimestre senza mantenere database di rendicontazione separati.
Schemi da copiare e incollare
Questi frammenti derivano dalla documentazione e dalla suite di test di MindooDB, così restano allineati all'uso reale.
Come l'indicizzazione incrementale entra nell'architettura MindooDB
In MindooDB il contenuto dei documenti è cifrato end-to-end. Il server archivia solo testo cifrato e non può eseguire query. È un compromesso deliberato a favore della sicurezza: riservatezza prima della comodità lato server. L'indicizzazione lato client restituisce le possibilità di interrogazione che ti aspetti — con la garanzia che i tuoi dati non siano mai esposti al server.
L'approccio incrementale mantiene tutto questo praticabile anche su grandi volumi. Invece di ricostruire gli indici da zero dopo ogni sincronizzazione, il cursore riprende esattamente da dove si era fermato ed elabora solo il delta. In un database con 100.000 documenti, di cui 50 cambiati dall'ultima sincronizzazione, l'indicizzatore elabora 50 documenti — non 100.000.
Lo store append-only di MindooDB è ciò che rende possibili tutti questi schemi. Poiché le modifiche non vengono mai sovrascritte:
- I cursori sono stabili — l'ordine delle modifiche non cambia, quindi riprendere da un cursore è sempre coerente
- Il viaggio nel tempo non costa nulla — la cronologia completa è già archiviata; non servono log o snapshot aggiuntivi
- Gli audit trail sono integrati — ogni modifica è firmata e datata dal suo autore
- Gli aggiornamenti incrementali sono corretti — il flusso delle modifiche è completo e ordinato; nessun aggiornamento va perso
È il contrario di quanto accade nei database modificabili, dove tracciare le modifiche, tenere la cronologia e indicizzare in modo incrementale richiede infrastruttura aggiuntiva (WAL, CDC, change stream, tabelle di audit).