Alles bevragen. Niets opnieuw verwerken.
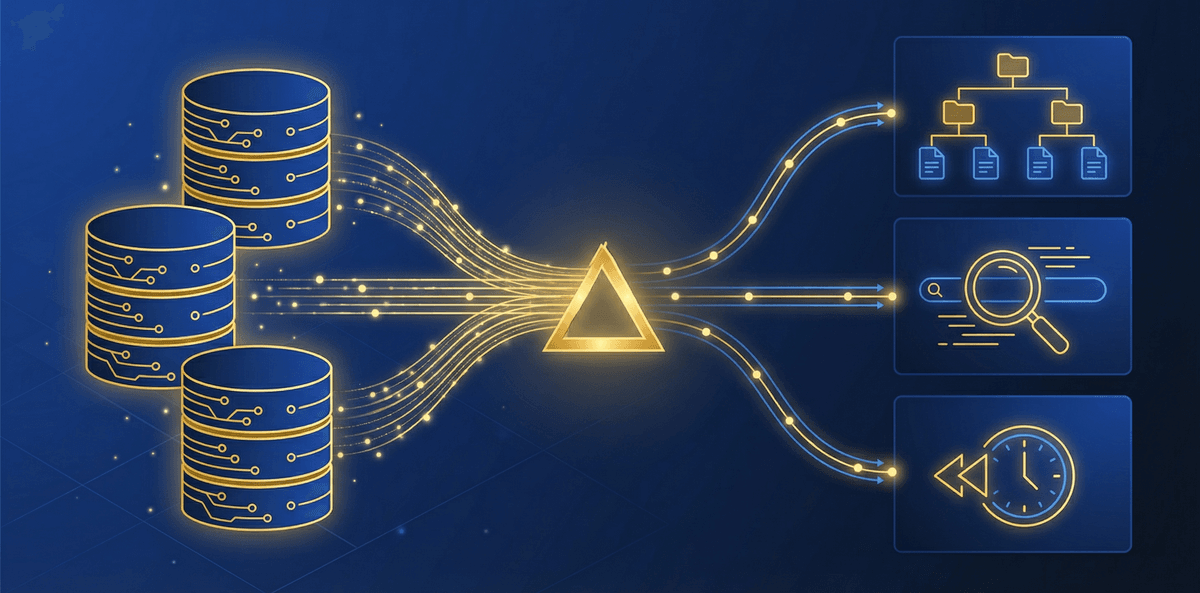
De append-only store en de cursorgebaseerde wijzigingsregistratie van MindooDB maken indexen mogelijk die actueel blijven door alleen te verwerken wat is gewijzigd — zonder ooit de hele database opnieuw te doorlopen. Hetzelfde primitief draagt virtuele weergaven, zoeken in de volledige tekst, synchronisatie met externe systemen en tijdreisquery's.
Waarom incrementele indexering ertoe doet
In end-to-end versleutelde databases kan de server geen query's uitvoeren — alle gegevens zijn versleuteld. MindooDB lost dat op met incrementele indexering op de client: één cursorgebaseerde API die alleen gewijzigde documenten verwerkt. Daarop draait alles, van hiërarchische rapportageweergaven tot zoeken in de volledige tekst en compliance-audits, zonder dat er ooit een volledige scan van de database nodig is. Het resultaat is voorspelbare prestatie die meeschaalt met het aantal wijzigingen, niet met de omvang van je gegevens.
iterateChangesSince() is de gemeenschappelijke basis voor virtuele weergaven, zoeken in de volledige tekst, synchronisatie met externe systemen en eigen analyses. Eén API leren, alle querypatronen benutten.
Virtuele weergaven spannen zich over meerdere databases binnen een tenant, over tenants heen, of mengen lokale en externe gegevens — zonder documenten te verplaatsen. Ideaal voor geconsolideerde dashboards en rapportage over organisaties heen.
De append-only store bewaart elke wijziging. Bevraag elke eerdere stand, vergelijk hoe documenten zich in de tijd ontwikkelden, maak databasesnapshots per peildatum en bouw volledige audittrails — allemaal uit dezelfde gegevens.
iterateChangesSince() — alleen verwerken wat is gewijzigd
Elke querystrategie in MindooDB begint bij hetzelfde primitief: een cursorgebaseerde asynchrone generator die documenten in volgorde van wijziging oplevert. Bij de eerste aanroep loopt hij de hele database door; bij elke volgende aanroep pakt hij precies op waar hij was gebleven. Verwijderde documenten komen mee met een verwijdermarkering, zodat indexen verderop kunnen opruimen. De kosten van elke ronde zijn evenredig aan het aantal wijzigingen sinds de vorige cursor — niet aan de totale omvang van de database.
- Cursorgebaseerd — geef
nullmee voor de eerste ronde, daarna de laatst teruggegeven cursor voor incrementele updates - Volgorde van wijziging — documenten komen met de oudste wijziging eerst, zodat indexen een consistent verloop zien
- Inclusief verwijderingen — verwijderde documenten verschijnen met de vlag
isDeleted()en zijn netjes uit indexen te halen - Batching door de consumer — de asynchrone generator laat zich op elk moment stoppen en later hervatten
- O(changed) — elke incrementele ronde verwerkt alleen documenten die sinds de vorige cursor zijn gewijzigd
- Geen volledige scans — de interne index houdt
(lastModified, docId)bij, zodat de cursor efficiënt kan hervatten - Verwisselbare consumers — één wijzigingsstroom kan meerdere indexers in één ronde voeden
- Werkt offline — indexen worden lokaal bijgewerkt; de synchronisatie haalt externe wijzigingen op en daarna verwerken de indexers het verschil
Hiërarchische weergaven met categorieën, sortering en totalen
Virtuele weergaven ordenen documenten in een boomstructuur in het geheugen — denk aan een dynamische inhoudsopgave die je gegevens categoriseert, sorteert en aggregeert. Geïnspireerd op het beproefde weergaveparadigma uit HCL Notes/Domino ondersteunen ze geneste categoriehiërarchieën, oplopend en aflopend sorteren over meerdere kolommen, en ingebouwde SUM- en AVERAGE-aggregaties op categorieregels. Updates gaan incrementeel: verandert een document, dan werkt de weergave alleen de betrokken takken bij.
- Categoriekolommen — groeperen documenten in geneste hiërarchieën (bijv. Afdeling > Jaar > Kwartaal)
- Sorteerkolommen — sorteren items binnen elke categorie op een of meer velden
- Totaalkolommen — automatisch SUM of AVERAGE per categorie, incrementeel bijgewerkt
- Weergavekolommen — extra gegevens naast elk item
- Waardefuncties — berekenen kolomwaarden dynamisch uit de documentgegevens
- Uit- en inklappen — categorieën openen of sluiten, net als in een bestandsbeheerder
- Navigatie op positie — direct naar "1.2.3" springen (eerste categorie, tweede subcategorie, derde item)
- Selectie — losse items of hele categorieën selecteren voor bulkbewerkingen
- Callbacks voor toegangscontrole — zichtbare items per gebruiker filteren zonder de structuur van de weergave te wijzigen
- Vooruit en achteruit doorlopen — de boom in beide richtingen aflopen
Eén weergave, veel databases — ook over tenants heen
Een van de sterkste eigenschappen van virtuele weergaven is dat ze documenten uit meerdere MindooDB-instanties in één samenhangende weergave kunnen samenbrengen. Elke gegevensbron wordt aangeduid met een "origin"-tekenreeks, dus je weet altijd uit welke database (en welke tenant) een document komt. Daarmee zijn geconsolideerde dashboards, rapportages over regio's heen en analyses over organisaties heen eenvoudig te bouwen — zonder gegevens te verplaatsen of te dupliceren.
Voeg een Amerikaanse en een Europese productdatabase samen tot één productcatalogus. De weergave categoriseert en sorteert over beide bronnen heen. Elk item draagt zijn origin, zodat je interface de regio van herkomst kan tonen.
Span weergaven over verschillende MindooTenants voor rapportage over organisaties heen. Twee organisaties delen gegevens in een derde tenant; een geconsolideerde weergave telt de omzet van alle drie bij elkaar op — en elke tenant houdt zijn eigen beheer.
Elke gegevensprovider houdt zijn eigen cursor bij. Een aanroep van view.update() verwerkt alleen de documenten die sinds de vorige ronde in de betreffende bron zijn gewijzigd. Met view.updateOrigin("us-products") werk je ook één origin apart bij.
Incrementele updates naar elke indexer of pipeline sturen
Hetzelfde primitief iterateChangesSince() dat virtuele weergaven draagt, kan elk extern systeem voeden. Houd er een index voor zoeken in de volledige tekst mee actueel, duw wijzigingen naar een analytics-pipeline of repliceer gegevens naar een externe dienst. Omdat de cursor precies bijhoudt welke documenten al zijn verwerkt, mist je integratie nooit een wijziging en verwerkt ze niets onnodig opnieuw.
Zoeken in de volledige tekst op de client is de natuurlijke aanvulling op end-to-end versleuteling — en MindooDB levert het standaard mee: een optioneel aan te zetten index die via de changefeed wordt bijgehouden (op basis van MiniSearch), versleuteld wordt opgeslagen en zich met op relevantie geordende resultaten direct in query's voegt.
- Veel soorten inhoud — platte tekst, Automerge-tekstvelden, rich-text-fragmenten, tekst uit bijlagen (PDF/Office)
- Integratie in query's — treffers in de volledige tekst combineren met gestructureerde filters en sortering op relevantie
- Taalbewust — tokenisatie via
Intl.Segmenter, per database in te stellen - Externe indexers — FlexSearch, Lunr.js of eigen systemen blijven aan te sluiten via de changefeed
Bouw datapipelines die op documentwijzigingen reageren. Door het patroon met asynchrone generatoren verwerk je wijzigingen in je eigen tempo, backpressure inbegrepen.
- Analytics-feeds — geaggregeerde cijfers naar dashboards sturen
- Webhook-triggers — externe systemen waarschuwen als bepaalde documenten wijzigen
- ETL-pipelines — gegevens extraheren en transformeren voor rapportagesystemen
- Replicatie — gegevens met exactly-once-semantiek naar secundaire systemen spiegelen
Een indexmanager kan meerdere indexers vanuit één wijzigingsstroom aansturen. Elk gewijzigd document wordt één keer verwerkt en de updates gaan in één ronde naar alle geregistreerde indexen — virtuele weergaven, zoeken in de volledige tekst, analytics en eigen consumers. Elke indexer houdt zijn eigen stand bij, dus een indexer toevoegen of opnieuw opbouwen raakt de andere niet.
Het verleden bevragen, wijzigingen vergelijken, audittrails opbouwen
De append-only store van MindooDB bewaart elke documentwijziging. Daaruit volgen drie sterke mogelijkheden: een document op elk historisch tijdstempel ophalen, de volledige wijzigingsgeschiedenis van een document doorlopen en alle documenten opsommen die op een bepaald moment bestonden. Samen dragen ze compliance-audits, versievergelijking, ongedaan maken en opnieuw doen, en databasesnapshots per peildatum.
getDocumentAtTimestamp()— haalt de stand van een document op elk eerder tijdstempel op, inclusief alle wijzigingen tot dat momentgetAllDocumentIdsAtTimestamp()— levert efficiënt alle document-ID's die op een bepaald moment bestonden, zonder inhoud te laden- Omgang met verwijderde documenten — onderscheidt "bestond nog niet" (levert
null) van "is verwijderd" (levert het document met de vlagisDeleted())
iterateDocumentHistory()— loopt elke wijziging af van het aanmaken tot de huidige stand, in chronologische volgorde- Metadata over de auteur — elke wijziging bevat het tijdstempel en de publieke ondertekeningssleutel van de gebruiker die haar maakte
- Onafhankelijke kopieën — elke opgeleverde documentversie is een zelfstandige stand, veilig om te bewaren en te vergelijken
- Wijzigingsdetectie — levert alleen op als het document echt is veranderd (updates zonder effect worden overgeslagen)
Aparte database-instanties, gesynchroniseerd tot elke datum
Omdat het sync-protocol van MindooDB losse wijzigingsvermeldingen met tijdstempel overdraagt, kun je een nieuwe database-instantie aanmaken en die alleen tot een bepaald tijdstip synchroniseren. Dat levert een bevroren stand van de database op dat moment — handig voor toezichtsaudits, reproduceerbare analyses of het vergelijken van gegevensstanden over periodes heen. De append-only store garandeert dat de snapshot volledig en manipulatievrij is.
Maak aan het eind van elk boekkwartaal een bevroren kopie van je database. Auditors kunnen documentstanden, handtekeningen van auteurs en wijzigingsgeschiedenis zelfstandig verifiëren — allemaal cryptografisch aantoonbaar.
Vergelijk documentverzamelingen op twee tijdstempels om te zien wat er tussendoor is aangemaakt, gewijzigd of verwijderd. Gecombineerd met getDocumentAtTimestamp() zie je precies hoe losse documenten zich hebben ontwikkeld.
Voer dezelfde virtuele weergave of query uit tegen databasesnapshots van verschillende datums. Vergelijk resultaten van maand tot maand of van kwartaal tot kwartaal zonder aparte rapportagedatabases bij te houden.
Patronen om te kopiëren
Deze fragmenten komen uit de MindooDB-documentatie en de testsuite, zodat ze aansluiten bij echt gebruik.
Hoe incrementele indexering in de MindooDB-architectuur past
In MindooDB is documentinhoud end-to-end versleuteld. De server slaat alleen versleutelde gegevens op en kan geen query's uitvoeren. Dat is een bewuste trade-off ten gunste van de beveiliging: vertrouwelijkheid boven gemak op de server. Indexeren op de client geeft je de vertrouwde querymogelijkheden terug — met de garantie dat je gegevens nooit aan de server worden prijsgegeven.
De incrementele aanpak houdt dat ook bij grote hoeveelheden praktisch. In plaats van indexen na elke synchronisatie opnieuw op te bouwen, pakt de cursor precies op waar hij was gebleven en verwerkt hij alleen het verschil. Bij een database met 100.000 documenten waarvan er 50 sinds de laatste synchronisatie zijn gewijzigd, verwerkt de indexer 50 documenten — niet 100.000.
De append-only store van MindooDB maakt al deze patronen pas mogelijk. Omdat wijzigingen nooit worden overschreven:
- Cursors zijn stabiel — de volgorde van wijzigingen verandert niet, dus hervatten vanaf een cursor is altijd consistent
- Tijdreizen kost niets extra — de volledige geschiedenis staat er al; extra logging of snapshots zijn niet nodig
- Audittrails zitten erin — elke wijziging wordt door haar auteur ondertekend en van een tijdstempel voorzien
- Incrementele updates kloppen — de wijzigingsstroom is volledig en geordend; er gaat geen update verloren
Dat staat tegenover veranderlijke databases, waar wijzigingsregistratie, geschiedenis en incrementele indexering extra infrastructuur vergen (WAL, CDC, change streams, audittabellen).